



在 C++ 中,二分查找是一种专门针对 “有序数据” 的高效查找方法。前面我们使用 std::find() 查找元素时,程序需要从头到尾挨个比对。如果容器里有上百万个数据,这种逐个排查的方式就会比较慢。
当容器里的元素已经按顺序排好时,使用二分查找的速度会快得多。你可以把它看成猜数字游戏:在 1~100 之间每次直接猜正中间的数,根据 “大了” 或 “小了” 的提示,每次都能排除掉一半的范围。
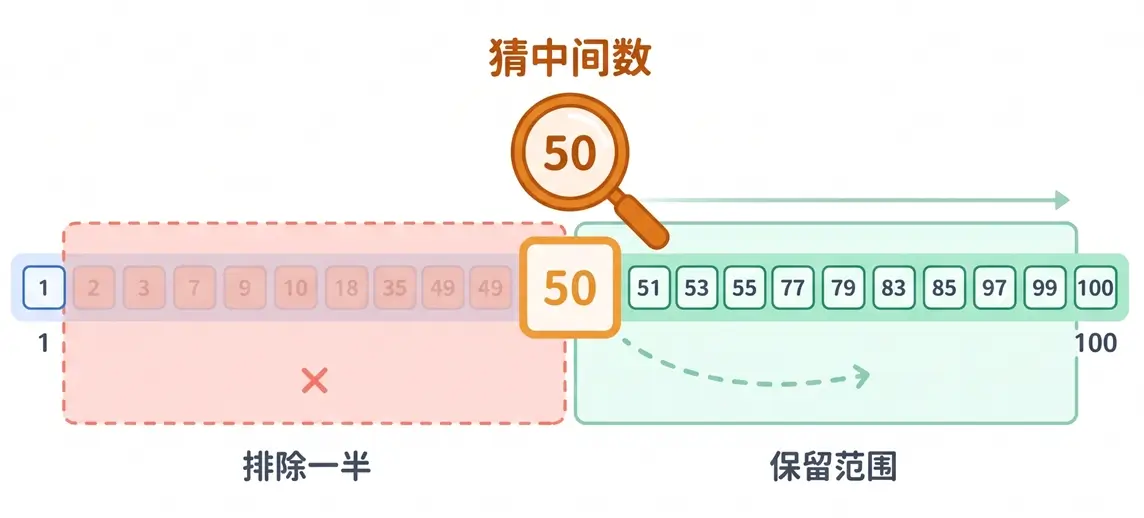
在 <algorithm> 头文件中,常用的二分查找函数主要有 3 个:① std::binary_search();② std::lower_bound();③ std::upper_bound()。
std::binary_search() 函数
如果我们只关心某个目标值在有序容器中 “存不存在”,直接使用 std::binary_search() 是最直观的。它会返回一个 bool 值:找到时返回 true;找不到时返回 false。
语法:
bool found = std::binary_search(first, last, value);说明:
first 和 last 分别表示查找范围的起始与结束边界,value 表示需要查找的目标值。需要特别注意的是,[first, last) 区间内的元素必须已经处于有序状态,默认要求按从小到大的升序排列。
示例 1:判断元素是否存在
#include <algorithm>
#include <iostream>
#include <vector>

int main() {
    // 容器中的元素已按从小到大排好序
    std::vector<int> nums = {10, 20, 30, 40, 50};

    if (std::binary_search(nums.begin(), nums.end(), 30)) {
        std::cout << "找到 30\n";
    }

    if (!std::binary_search(nums.begin(), nums.end(), 25)) {
        std::cout << "没有找到 25\n";
    }
    return 0;
}运行结果如下。
找到 30
没有找到 25
分析:
在这个例子中,我们第 1 次调用 std::binary_search() 查找 30 时,函数直接检查正中间的元素 30,一次就比对成功并返回 true。
而在第 2 次查找 25 时,函数发现中间的 30 比 25 大,就会直接跳过右半边的 40 和 50。接着它只去左半边的 10 和 20 里继续折半查找,最终确认不存在并返回 false。
二分查找之所以能每次排除一半数据,完全建立在 “元素已经排好序” 的前提上。如果容器里的元素还是乱序的就直接调用 std::binary_search(),就会得出错误的结果。请看下面例子。
示例 2:先排序再二分查找
#include <algorithm>
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {30, 10, 40, 20};

    // 未排序直接二分查找
    bool res1 = std::binary_search(nums.begin(), nums.end(), 10);
    std::cout << res1 << '\n';

    // 先排序再执行二分查找
    std::sort(nums.begin(), nums.end());
    bool res2 = std::binary_search(nums.begin(), nums.end(), 10);
    std::cout << res2 << '\n';
    return 0;
}运行结果如下。
0
1
分析:
从运行结果可以看出,nums 原本是乱序的 {30, 10, 40, 20},第 1 次查找 10 却输出了 0(即 false)。这是因为函数看到中间元素比 10 大便去左边找,而最左边放的是 30,于是误判没有 10。
当我们先调用 std::sort() 把容器排成有序的 {10, 20, 30, 40} 后,再次执行二分查找就能正常输出 1(即 true)了。另外,如果容器原本是按降序排好序的,调用时需要在第 4 个参数传入相同的降序规则,写法如下:
// 传入与容器一致的降序规则
bool res = std::binary_search(nums.begin(), nums.end(), 10,
    [](int a, int b) { return a > b; });
注意 在使用任何二分查找函数之前,我们必须确保区间内的元素已经处于有序状态。如果原数据是乱序的,小伙伴们记得先调用 std::sort() 排好序,再执行二分查找。
std::lower_bound() 和 std::upper_bound()
std::binary_search() 只会回答目标值 “有没有”,并不会告诉我们它 “排在哪个位置”。如果想要获取目标元素所在的位置或者计算它的下标,我们就需要使用 std::lower_bound() 和 std::upper_bound()。
语法:
auto it1 = std::lower_bound(first, last, value);
auto it2 = std::upper_bound(first, last, value);
说明:
这两个函数的参数与 std::binary_search() 完全一样,但查找规则不同,返回的都是迭代器:
- std::lower_bound():在有序区间
[first, last)中,查找第 1 个 “大于或等于value” 的元素,并返回指向该元素的迭代器。 - std::upper_bound():在有序区间
[first, last)中,查找第 1 个 “严格大于value” 的元素,并返回指向该元素的迭代器。
如果区间内所有元素都比 value 小,找不到满足条件的元素,这两个函数都会返回结束边界 last。
初学时如果容易把这两个名字记混,可以结合插入位置来理解:下界 lower_bound() 对应保持有序时可插入的最左位置,上界 upper_bound() 对应最右位置。小伙伴们记住一句窍门即可:下界带等号 >=,上界不带等号 >。
1. 使用 std::lower_bound() 查找下标
在实际开发中,当我们想通过二分查找定位某个元素的下标时,最常用的是 std::lower_bound()。
示例 3:查找目标元素的下标
#include <algorithm>
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {10, 20, 30, 40, 50};

    // 1. 查找存在的元素 30
    auto it1 = std::lower_bound(nums.begin(), nums.end(), 30);
    if (it1 != nums.end() && *it1 == 30) {
        auto idx = it1 - nums.begin();
        std::cout << "找到 30,下标为:" << idx << '\n';
    }

    // 2. 查找不存在的元素 25
    auto it2 = std::lower_bound(nums.begin(), nums.end(), 25);
    if (it2 != nums.end() && *it2 == 25) {
        std::cout << "找到 25\n";
    } else {
        std::cout << "未找到 25\n";
    }
    return 0;
}运行结果如下。
找到 30,下标为:2
未找到 25
分析:
在这个例子中,我们第 1 次查找 30 时,std::lower_bound() 寻找第 1 个 >= 30 的元素。找到的目标刚好就是 30 本身,通过 it1 - nums.begin() 算出的下标为 2。
重点看第 2 次查找 25:容器里并没有 25,但函数找的是第 1 个 >= 25 的元素,因此 it2 实际指向了 30,而不是 nums.end()。所以判断目标值是否真正存在时,必须同时检查 it2 != nums.end() 和 *it2 == 25。
// 正确方式
if (it2 != nums.end() && *it2 == 25) { ... }

// 错误方式
if (it2 != nums.end()) { ... }
同时大家还要留意 && 两边的顺序:一定要先写 it2 != nums.end(),再写 *it2 == 25。假如查找比所有元素都大的数(比如 60),返回的就是 nums.end(),先判断边界才能避免越界解引用。
2. 配合 std::upper_bound() 统计次数
当有序容器中存在多个重复元素时,这两个函数的配合就非常实用了。假设有序容器中的数据为 {10, 20, 20, 20, 30}(下标为 0 到 4),查找 20 时它们指向的位置如下:
- std::lower_bound():找第 1 个
>= 20的元素,因此指向下标 1 处的第 1 个 20。 - std::upper_bound():找第 1 个
> 20的元素,因此指向最后一个 20 后面的 30(下标为 4)。
可以看到,它们刚好卡住了所有 20 所在的左闭右开区间 [1, 4)。我们将上界迭代器减去下界迭代器,就能直接算出重复元素出现的总次数。下面我们来看一个例子。
示例 4:统计重复元素的次数
#include <algorithm>
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {10, 20, 20, 20, 30};

    auto low = std::lower_bound(nums.begin(), nums.end(), 20);
    auto up = std::upper_bound(nums.begin(), nums.end(), 20);

    std::cout << "下界下标:" << (low - nums.begin()) << '\n';
    std::cout << "上界下标:" << (up - nums.begin()) << '\n';
    std::cout << "出现次数:" << (up - low) << '\n';
    return 0;
}运行结果如下。
下界下标:1
上界下标:4
出现次数:3
分析:
low 指向下标 1 处的第 1 个 20,up 指向下标 4 处的元素 30。通过 up - low 将两个迭代器相减,一步就能算出 20 在有序容器中一共出现了 3 次。即使容器里根本没有目标值,low 和 up 也会指向同一个位置,相减结果自然为 0。
在实际开发中,如果我们只关心元素存不存在,直接使用 std::binary_search() 最简洁。如果需要定位目标元素的下标或统计重复个数,再配合使用 std::lower_bound() 和 std::upper_bound() 即可。
常见问题
1. 二分查找这么快,为什么不把所有的 std::find() 都换成二分查找?
因为二分查找要求数据必须提前排好序。如果容器原本是乱序的,而我们只需要查找一次,先调用 std::sort() 排序再二分查找,总耗时反而比直接用 std::find() 从头扫一遍更慢。
只有当容器本身就已经有序,或者 “排序一次、后续反复查找很多次” 时,二分查找的高效率才能真正发挥出来。
2. list 双向链表适合使用 std::binary_search() 吗?
不适合。虽然语法上可以把 list 的迭代器传给二分查找函数,但 list 的迭代器不支持 it + n 跨步跳转,底层定位中间元素时依然只能一步步挪动节点,无法发挥二分查找快速跳转的优势。
