



当多个线程同时读写同一个普通变量时,很容易因为执行步骤互相交错而引发 “数据竞争”,导致算出来的结果出错。为了解决这个问题,C++ 在 <mutex> 头文件中提供了 std::mutex 互斥锁(也叫互斥量),其中 mutex 是 “mutual exclusion(互斥)” 的缩写。
使用 std::mutex 就相当于给共享房间的门装上了一把锁:同一时刻只允许一个线程拿到锁进入房间修改数据,其他线程必须在门外排队等待,直到里面的线程改完数据并把锁交出来为止,如下图所示。
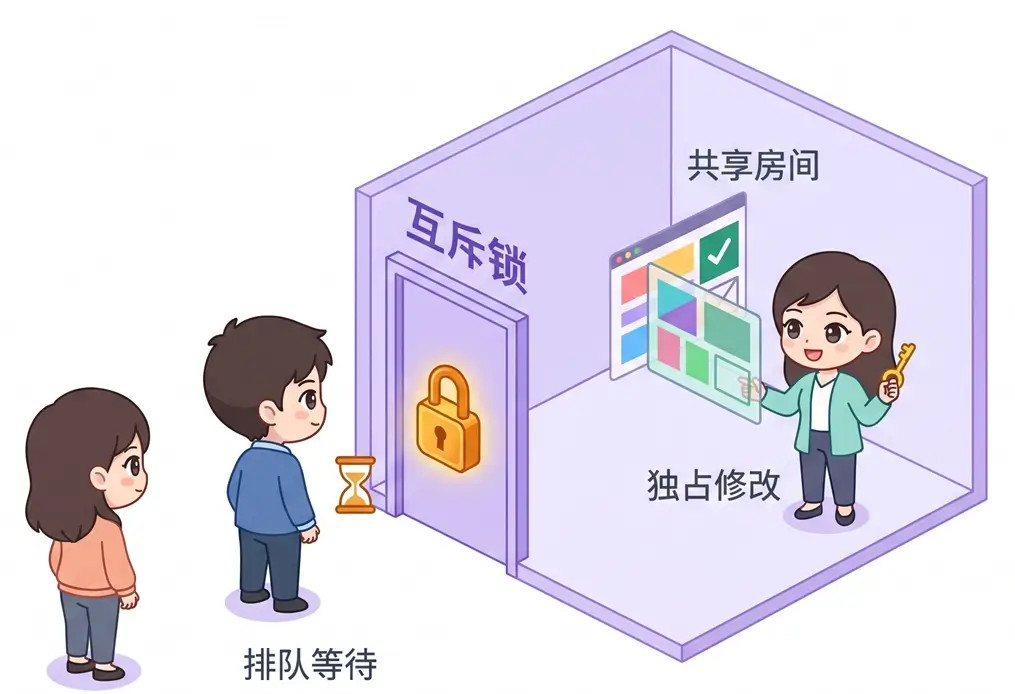
C++ mutex 基本用法
在 C++ 中使用 std::mutex 时,我们需要先定义一个供多个线程共用的互斥锁对象。每次访问共享数据之前先调用 lock() 加锁,访问结束之后立刻调用 unlock() 解锁。
语法:
#include <mutex>

std::mutex 互斥锁名;

互斥锁名.lock();
// 操作共享数据
互斥锁名.unlock();
说明:
被 lock() 和 unlock() 包裹起来、同一时刻只允许一个线程执行的那段代码,通常称为 “临界区(critical section)”。这两个成员函数的作用如下:
- lock():尝试获取这把锁。如果此时锁是空闲的,当前线程就会拿到锁并继续往下执行。如果锁已经被其他线程拿走了,当前线程就会停在
lock()这一行排队等待。 - unlock():操作完共享数据后释放这把锁,让门外正在排队等待的其他线程有机会拿到锁。
示例 1:保护共享计数器
#include <iostream>
#include <mutex>
#include <thread>

int counter = 0;
std::mutex mtx;

void addCount() {
    for (int i = 0; i < 100000; i++) {
        mtx.lock();      // 访问前加锁
        counter++;
        mtx.unlock();    // 访问后解锁
    }
}

int main() {
    std::thread t1(addCount);
    std::thread t2(addCount);

    t1.join();
    t2.join();

    std::cout << "最终计数:" << counter << "\n";
    return 0;
}运行结果如下。
最终计数:200000分析:
在这个例子中,我们通过 std::thread 启动了 t1 和 t2 两个子线程,并使用 mtx.lock() 和 mtx.unlock() 将 counter++; 包裹成了受保护的临界区。
当 t1 拿到锁正在修改 counter 时,t2 必须在 mtx.lock(); 处排队等待。直到 t1 调用 mtx.unlock(); 释放锁之后,t2 才能进入临界区执行自增,因此最终结果稳定为 200000。
对于这个例子来说,如果我们把 mtx.lock(); 和 mtx.unlock(); 这两行去掉,每次运行都会算出一个小于 200000 的随机错误结果,比如:
最终计数:143820可能有些小伙伴会觉得奇怪:为什么把互斥锁去掉之后,简简单单的一行 counter++ 会算错呢?
这是因为 counter++ 表面上看只有一行代码,但在 CPU 底层执行时,实际上分成了 3 步:① 从内存读取 counter 的当前值;② 将读出来的值加 1;③ 把新值写回 counter。如果没有互斥锁保护,假设当前 counter 的值是 0,两个线程的执行步骤很可能会按下面的先后顺序交错:
- 线程
t1从内存读取counter的值,拿到 0。 - 线程
t2也从内存读取counter的值,同样拿到 0。 - 线程
t1计算0 + 1,将结果 1 写回counter。 - 线程
t2也计算0 + 1,同样将结果 1 写回counter。
从上面的过程可以看出,两个线程明明各自执行了一次 counter++。但由于它们同时读到了同一个旧值 0,最后写回内存的结果却只是 1,白白漏算了一次自增。
提示 加上 std::mutex 之后,程序并不会退化成单线程。互斥锁只作用在 lock() 到 unlock() 之间那一小段修改共享数据的代码上,临界区之外的其他代码依然由多个线程并行执行。
使用 try_lock() 尝试加锁
前面使用的 lock() 属于 “阻塞等待” 模式:只要锁还在别的线程手里,当前线程就会一直停在原地干等。如果有时我们希望拿到锁就处理数据,拿不到锁也不停下来等待,而是先去做别的事情,就可以使用 try_lock() 成员函数。
语法:
if (互斥锁名.try_lock()) {
    // 操作共享数据
    互斥锁名.unlock();
} else {
    // 去做其他事情
}
说明:
调用 try_lock() 时,当前线程不会停下来排队,而是立刻返回一个布尔值(bool):
- 返回 true:表示锁原本是空闲的,当前线程已经成功拿到了锁,我们操作完共享数据后必须记得调用
unlock()解锁。 - 返回 false:表示锁此时正被其他线程占用,当前线程没有拿到锁。注意此时锁不在我们手里,千万不要调用
unlock()。
示例 2:锁被占用时跳过等待
#include <iostream>
#include <mutex>
#include <thread>

std::mutex mtx;

void tryTask(int id) {
    if (mtx.try_lock()) {
        std::cout << "线程 " << id << ":拿到锁,开始处理数据\n";
        mtx.unlock();
    } else {
        std::cout << "线程 " << id << ":锁被占用,先做其他事\n";
    }
}

int main() {
    mtx.lock();                    // 主线程先占住锁
    std::thread t1(tryTask, 1);
    t1.join();
    mtx.unlock();                  // 主线程释放锁

    std::thread t2(tryTask, 2);    // 锁已空闲,再次尝试
    t2.join();
    return 0;
}运行结果如下。
线程 1:锁被占用,先做其他事
线程 2:拿到锁,开始处理数据
分析:
mtx.try_lock() 表示在不阻塞当前线程的前提下尝试获取互斥锁。在启动子线程 t1 之前,我们先在主线程里调用 mtx.lock() 把锁占住了。因此当 t1 执行 if (mtx.try_lock()) 时,不会停在原地等待,而是立刻得到 false 并直接进入 else 分支。
等主线程调用 mtx.unlock() 把锁释放之后,子线程 t2 再次调用 try_lock() 就会返回 true。此时 t2 顺利进入 if 分支处理数据,并在用完后调用 mtx.unlock() 归还互斥锁。
使用 mutex 的注意事项
刚接触 std::mutex 的小伙伴,往往容易误以为 “只要在代码里定义了一个 mutex 变量,共享数据就自动安全了”。实际上,std::mutex 本身并不知道我们要保护哪一个变量。要让互斥锁真正发挥作用,我们需要遵守以下 3 条规则:
- 多个线程必须共用同一把锁:我们应该把
std::mutex定义为全局变量或类成员变量等所有相关线程都能访问到的对象,千万不要把它定义成线程函数内部的局部变量。 - 临界区范围应该尽量短小:我们只把真正读写共享数据的那几行代码放进
lock()和unlock()之间。与共享数据无关的耗时计算或等待操作,应该尽量放在锁的外面,避免其他线程长时间排队。 - 配对解锁且避免同线程重复加锁:调用
lock()后如果漏写了unlock(),其他排队的线程就会一直卡住。同时,同一个线程在还没解锁时千万不要对同一把std::mutex再次调用lock()。这在 C++ 中属于未定义行为,最常见的后果就是线程停在原地等自己放锁,把程序彻底卡死(即 “死锁”)。
对于第 1 点,如果我们把 std::mutex 错写成了线程函数内部的局部变量,那么每个线程进入函数时都会各自创建一把新锁。这样一来,大家各锁各的,根本锁不住共享变量,这一点小伙伴们千万不要搞混了。
// 正确方式
std::mutex mtx;
void addSafe() {
    mtx.lock();
    counter++;
    mtx.unlock();
}

// 错误方式
void addBad() {
    std::mutex badMtx;
    badMtx.lock();
    counter++;
    badMtx.unlock();
}
此外,直接手写 lock() 和 unlock() 还隐藏着另一个风险。如果临界区中间遇到了提前 return 或抛出了异常,程序就会直接跳出当前函数,导致后面的 unlock() 根本没有机会执行。为了避免忘记解锁,在实际开发中我们通常会配合 std::lock_guard 来自动管理锁的释放。
