



在实际开发中,模拟掷骰子、活动抽奖或生成随机验证码时,我们都需要让程序随机产生一个数字。
从 C++11 标准开始,C++ 提供了专门的 <random> 标准库来生成随机数。它将随机数的生成拆分为 “种子 → 随机引擎 → 分布器 → 随机结果” 4 个环节。
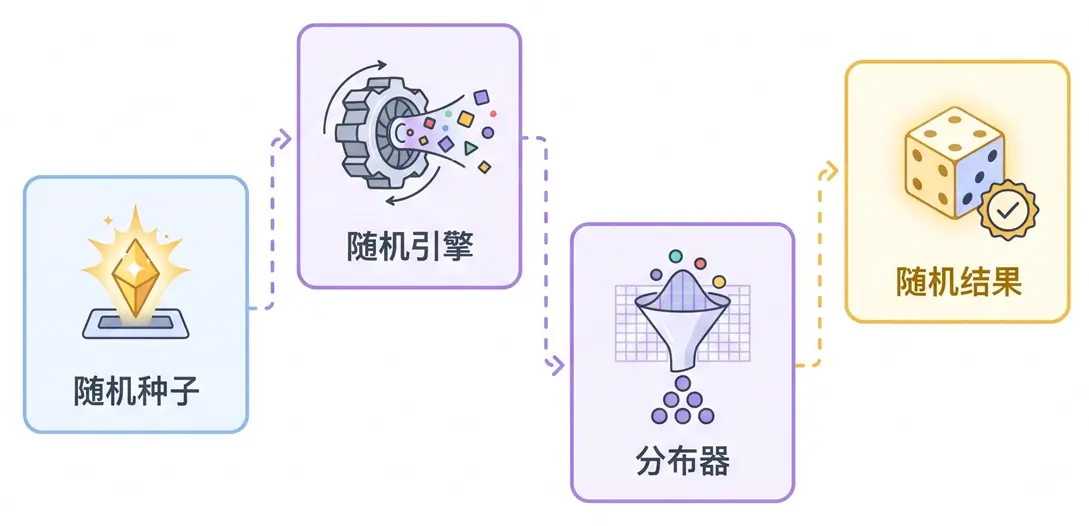
第一次看到 <random> 里的类型名字时,小伙伴们可能会觉得稍微有点长。其实生成随机数的这几行代码是固定写法,我们只需要弄清这 4 个环节的分工,平时直接套用并修改范围即可,不用死记硬背。
C++ 随机数生成原理
在 <random> 标准库中,生成随机数需要 4 个角色相互配合。你可以把整套流程想象成一台 “摇奖机”,各个角色的分工如下表所示。
| 角色名称 | 常用写法 | 功能说明 |
|---|---|---|
| 种子(seed) | std::random_device rd; | 提供初始状态,决定随机引擎从哪个起点开始计算 |
| 随机引擎(engine) | std::mt19937 engine(rd()); | 根据种子不断产生原始的伪随机序列 |
| 分布器(distribution) | std::uniform_int_distribution<int> dist(1, 100); | 将原始随机值均匀映射到指定范围,如 1 ~ 100 |
| 随机结果(result) | dist(engine) | 把引擎传给分布器,摇出一个符合范围要求的随机数 |
在这 4 个角色中,初学者最容易搞混的是 “随机引擎” 和 “分布器”。简单来说,随机引擎 std::mt19937 只负责不停产生原始随机值,它本身并不知道我们需要 1 ~ 100 的整数,还是 0.0 ~ 1.0 的小数。真正决定最终数字范围和数据类型的,是后面的分布器。
生成指定范围的随机整数
在 C++ 中,如果要生成指定范围内的均匀随机整数,我们可以使用 <random> 头文件中的 std::uniform_int_distribution。
从英文单词上很容易记住它的名字:uniform(均匀的)、int(整数)加上 distribution(分布),合起来就是 “均匀整数分布”,表示指定范围内的每一个整数被抽中的概率完全相等。
语法:
std::random_device rd;
std::mt19937 engine(rd());
std::uniform_int_distribution<int> dist(minVal, maxVal);
int num = dist(engine);
说明:
std::mt19937 是标准库中最常用的通用伪随机数引擎,名字里的 19937 来自其内部梅森旋转算法的周期指数,平时直接当成固定名称使用即可。
其中,分布器括号里的 minVal 和 maxVal 用来指定闭区间范围,最小值和最大值本身都可能被抽中。比如 dist(1, 100) 生成的随机整数就包含 1 和 100。
示例 1:生成随机整数
#include <iostream>
#include <random>

int main() {
    // 初始化随机种子与引擎
    std::random_device rd;
    std::mt19937 engine(rd());

    // 定义 1 ~ 100 的均匀整数分布
    std::uniform_int_distribution<int> dist(1, 100);

    for (int i = 0; i < 5; i++) {
        std::cout << dist(engine) << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
62 75 61 52 92 分析:
上面代码先通过 rd() 获取随机种子并初始化引擎 engine,接着定义了 1 ~ 100 的均匀整数分布器 dist,最后在 for 循环中连续抽取了 5 个随机数。由于每次运行时的初始种子都会变化,小伙伴们在自己电脑上看到的 5 个数字通常也会和上面不同。
另外,代码里的 rd 和 dist 本身都是对象。它们之所以能在后面加上小括号写成 rd() 和 dist(engine),是因为 C++ 支持通过运算符重载把对象当成函数来调用。执行一次 rd() 就获取一个随机种子,执行一次 dist(engine) 就摇出一个随机数。
在实际开发中,有一个新手很容易踩坑的地方:随机引擎和分布器一定要放在循环外部创建,在循环内部只调用 dist(engine),千万不要把引擎的创建写进循环里面。
// 正确方式
std::random_device rd;
std::mt19937 engine(rd());
std::uniform_int_distribution<int> dist(1, 100);
for (int i = 0; i < 5; i++) {
    std::cout << dist(engine) << ' ';
}

// 错误方式
for (int i = 0; i < 5; i++) {
    std::random_device rd;
    std::mt19937 engine(rd());
    std::uniform_int_distribution<int> dist(1, 100);
    std::cout << dist(engine) << ' ';
}
在错误方式中,每次循环都会重新创建并初始化一台新引擎,不仅运行效率很低,在部分系统环境下甚至会导致每次循环摇出相同的数字。因此大家记住一句话:引擎和分布器只初始化一次,循环内部只重复调用 dist(engine) 抽数即可。
使用固定种子复现结果
计算机里的随机引擎本质上都是 “伪随机”,它会按照一套确定的数学公式一步步算出下一个值,而种子决定了它从哪个起点开始算。只要给同一个引擎传入相同的固定整数作为种子,每次运行程序都会产生一模一样的随机序列。
这个特性在复现程序问题和编写测试代码时非常实用。下面我们来看一个例子。
示例 2:使用固定种子掷骰子
#include <iostream>
#include <random>

int main() {
    std::mt19937 engine(42);    // 传入固定整数作为种子
    std::uniform_int_distribution<int> dist(1, 6);

    for (int i = 0; i < 5; i++) {
        std::cout << dist(engine) << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
3 5 6 2 5 分析:
std::mt19937 engine(42); 表示直接把固定整数 42 作为种子传给 engine,省去了 std::random_device。这里的 42 只是一个任意选定的测试整数,换成 100 或 2026 也可以。
在相同的编译器和标准库环境下,无论把这段代码运行多少遍,输出的序列都会固定是 3、5、6、2、5。平时写代码时,我们可以按以下 2 种场景来选择种子:
- 正式业务场景:需要每次运行结果都不同时,我们使用
std::random_device rd;配合std::mt19937 engine(rd());提供随机种子。 - 调试与测试场景:需要反复重现同一批随机数据时,我们直接向引擎传入固定整数,比如写成
std::mt19937 engine(42);,用来锁定随机序列方便排查问题。
生成指定范围的随机浮点数
掌握了随机整数之后,生成随机浮点数就很简单了。我们不需要更换随机引擎,只需要把分布器换成 std::uniform_real_distribution 即可。其中,real 是英文 “实数” 的意思,表示均匀实数分布。
语法:
std::uniform_real_distribution<double> dist(minVal, maxVal);
double num = dist(engine);
说明:
与整数分布不同,std::uniform_real_distribution 生成的浮点数范围是 “左闭右开” 区间,也就是包含最小值 minVal,但不包含最大值 maxVal。比如 dist(0.0, 1.0) 会生成大于或等于 0.0 且小于 1.0 的随机小数。
示例 3:生成随机浮点数
#include <iostream>
#include <random>

int main() {
    std::random_device rd;
    std::mt19937 engine(rd());

    // 0.0 ~ 1.0 的浮点分布
    std::uniform_real_distribution<double> dist1(0.0, 1.0);
    // 10.0 ~ 20.0 的浮点分布
    std::uniform_real_distribution<double> dist2(10.0, 20.0);

    std::cout << dist1(engine) << '\n';
    std::cout << dist2(engine) << '\n';
    return 0;
}运行结果如下。
0.374541
17.9654
分析:
这里 dist1(engine) 和 dist2(engine) 共用了同一个随机引擎 engine,每次运行输出的随机小数也会随随机种子变化。可以看到,引擎只负责提供随机源,我们需要什么范围和类型的数据,搭配对应的分布器即可。
注意 std::mt19937 适合游戏开发、日常抽奖和数据模拟,但它并不是为密码学安全设计的。如果涉及生成加密密钥或高安全级别的登录令牌,我们需要使用操作系统或专门加密库提供的安全随机接口,不能直接使用 std::mt19937。
生成随机验证码
平时登录网站或软件时,我们经常会看到由数字和字母随机组合而成的 4 位验证码。借助前面学过的均匀整数分布,我们可以很轻松地实现这个功能。
实现思路很简单:先定义一个 std::string 字符串保存所有候选字符。假设共有 n 个字符,有效下标范围就是 0 到 n - 1。我们每次随机抽一个有效下标并取出对应字符,循环拼接 4 次即可。请看下面例子。
示例 4:随机拼接 4 位验证码
#include <iostream>
#include <random>
#include <string>

int main() {
    std::string chars = "0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ";

    std::random_device rd;
    std::mt19937 engine(rd());

    int maxIdx = chars.size() - 1;
    std::uniform_int_distribution<int> dist(0, maxIdx);

    std::string code;
    for (int i = 0; i < 4; i++) {
        code += chars[dist(engine)];    // 随机抽取字符并拼接
    }

    std::cout << "随机验证码:" << code << '\n';
    return 0;
}运行结果如下。
随机验证码:U4XA分析:
在这个例子中,我们先调用字符串的 size() 方法获取候选字符总数(共 36 个),减 1 后得到最大合法下标 maxIdx(即 35)。
由于均匀整数分布包含左右两个端点,dist(0, maxIdx) 每次都会均匀抽中 0 ~ 35 之间的合法下标,不会发生越界。平时小伙伴们需要从数组或 std::vector 容器中随机抽取元素时,也可以直接使用这套写法。
常见问题
1. 为什么现代 C++ 推荐使用 <random>,而不是旧版的 rand() 函数?
在 <cstdlib> 头文件中确实保留了从 C 语言继承来的 std::rand() 函数,平时阅读旧代码时认识即可。但在编写现代 C++ 代码时,我们更推荐使用 <random>,主要有以下 2 个原因:
避免求余导致概率不均:旧代码常写 rand() % 100 + 1 来获取 1 ~ 100 的随机数。由于 rand() 的上限 RAND_MAX 通常不是 100 的整数倍,直接求余会让偏小的数字更容易被抽中,而 std::uniform_int_distribution 能保证每个数字的概率相等。
随机质量更高且状态独立:rand() 生成的随机序列周期较短,在部分平台上最大值仅为 32767。同时它依赖全局状态,在多线程环境下容易相互干扰。而 <random> 中的每个 engine 对象都是彼此独立的,既安全又方便单独设置种子。
