



平时我们在函数内部定义普通变量时,经常会写出下面这样的代码:
void test() {
    int a = 10;
}
一旦 test() 函数执行完毕,里面的局部变量 a 就会跟着自动销毁。那如果我们希望在函数里创建一个对象,并且在函数结束后还能继续使用它,数据应该存放在哪里呢?
这就涉及到 C++ 程序运行期间最常用的两块内存区域:一种是 “栈内存(Stack)”,另一种是 “堆内存(Heap)”。
你可以把栈内存想象成快餐店里按顺序叠放餐盘的托盘架,随用随取、用完自动收回,但架子高度有限。而堆内存就像一个大仓库,空间充足、租期自由,但什么时候借、什么时候还都需要我们自己管理,如下图所示。
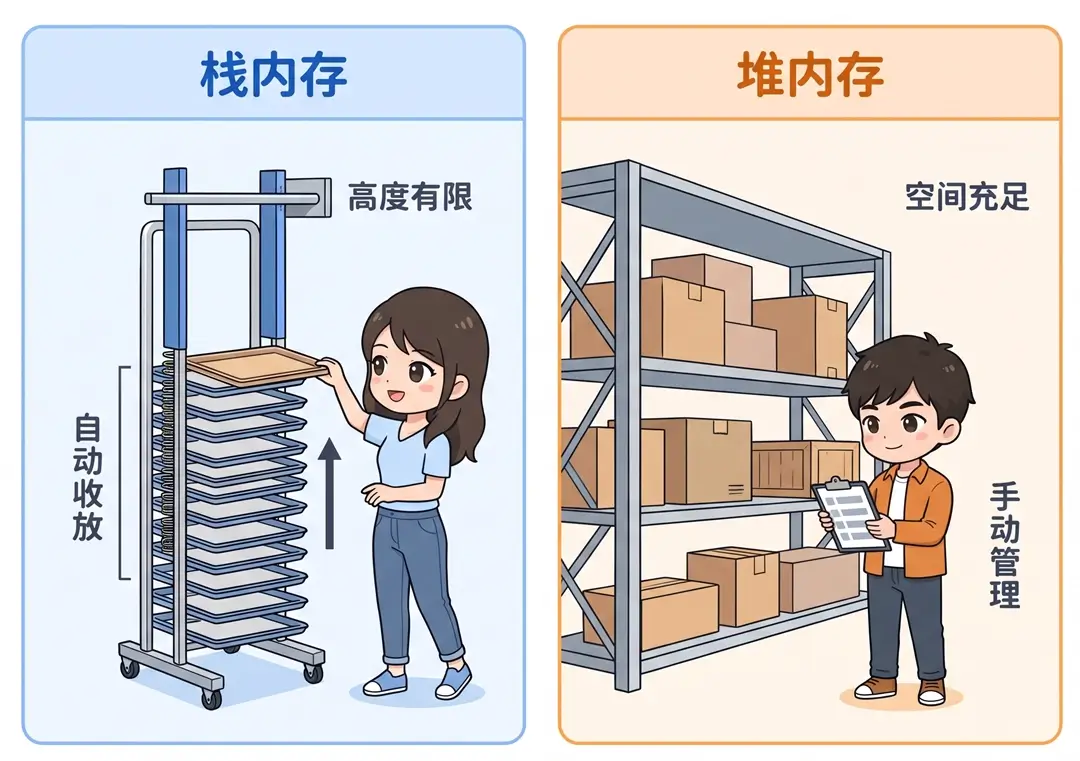
简单来说,存放在栈内存上的对象常简称为 “栈对象”,存放在堆内存上的对象常简称为 “堆对象”。一个对象放在哪里,直接决定了它由谁管理、什么时候销毁。
C++ 栈内存
在 C++ 中,当我们在函数或花括号代码块内部直接定义一个普通变量或局部对象时,这个对象就存放在栈内存上。
栈内存最大的特点就是 “全自动”,对象的内存分配和销毁都不需要我们操心。当程序执行到定义语句时,编译器会自动在栈上分配空间。一旦程序离开它所在的作用域,栈对象就会自动调用析构函数并收回内存空间。
如果在同一个作用域里连续定义了多个栈对象,它们会像叠放餐盘一样遵循 “后进先出” 的顺序:先创建的对象后销毁,后创建的对象反而先销毁。下面我们来看一个例子。
示例 1:栈对象的自动创建与销毁
#include <iostream>
#include <string>

class Book {
private:
    std::string name;

public:
    Book(const std::string& n) : name(n) {
        std::cout << name << ":对象创建\n";
    }

    ~Book() {
        std::cout << name << ":对象销毁\n";
    }
};

void readBook() {
    Book b1("C++ 基础");
    Book b2("C++ 进阶");
    std::cout << "正在阅读图书\n";
}

int main() {
    std::cout << "1. 准备调用 readBook()\n";
    readBook();
    std::cout << "2. 已回到 main()\n";
    return 0;
}运行结果如下。
1. 准备调用 readBook()
C++ 基础:对象创建
C++ 进阶:对象创建
正在阅读图书
C++ 进阶:对象销毁
C++ 基础:对象销毁
2. 已回到 main()
分析:
在这个例子中,readBook() 函数内部依次定义了 b1 和 b2 两个栈对象。当函数执行到末尾的右花括号 } 时,它们会在回到 main() 之前自动销毁。哪怕函数在中途遇到 return 提前退出,栈对象同样会自动销毁。
同时小伙伴们可以留意一下销毁的先后顺序:b1 先创建、b2 后创建,离开函数时却是 b2 先销毁、b1 后销毁,正好符合栈内存 “后进先出” 的特点。
此外,栈内存的分配和读写速度虽然非常快,但它的总容量通常只有几 MB。如果我们在函数内部直接定义 int arr[10000000] 这样超大的局部数组,或者递归调用缺少退出条件,就会把栈空间耗尽,引发常见的 “栈溢出(Stack Overflow)” 崩溃。
作用域与生命周期的区别
初学 C++ 时,很多小伙伴容易把 “作用域(Scope)” 和 “生命周期(Lifetime)” 当成一回事。因为对于普通的栈对象来说,离开代码块时名字不能再用了,对象本身也刚好销毁了。实际上,这两个概念关注的是不同角度:
作用域:决定 “这个名字在哪一段代码中可以直接看见并使用”。
生命周期:决定 “这个对象在程序运行期间什么时候真实存在于内存中”。
举个简单的例子,如果在函数内部定义一个静态局部对象 static Book b("C++"),它会存放在专门的静态存储区,既不在栈上也不在堆上。它的作用域依然只限于当前函数内部,但生命周期会一直持续到整个程序结束。
C++ 堆内存
栈内存虽然省心,但对象的存活时间限制在了当前函数里。如果我们在函数内定义一个栈对象,再把它的地址返回给外部,函数结束的瞬间该对象就会销毁,外部拿到的地址也就失效了。因此,当对象需要跨函数继续存活,或者需要申请一块较大的内存时,我们就要使用堆内存。
在 C++ 中,我们可以使用 new 和 delete 运算符来手动管理堆内存。和栈对象不同,堆内存上创建出来的对象本身没有变量名,只能靠内存地址来找到它。
因此,new 在堆上创建好对象后会返回它的内存地址,我们需要使用指针把它保存起来,用完后再通过 delete 手动销毁。关于这两个运算符的具体用法,我们会在下一节 “C++ new 和 delete” 中展开介绍,这里先来看一个例子。
示例 2:堆对象的跨函数存活
#include <iostream>
#include <string>

class Book {
private:
    std::string name;

public:
    Book(const std::string& n) : name(n) {
        std::cout << name << ":对象创建\n";
    }

    ~Book() {
        std::cout << name << ":对象销毁\n";
    }
};

Book* createBook() {
    Book* p = new Book("C++ 教程");    // 在堆上创建对象
    std::cout << "createBook() 执行完毕\n";
    return p;
}

int main() {
    Book* bookPtr = createBook();
    std::cout << "已回到 main(),堆对象仍存在\n";
    delete bookPtr;                    // 手动销毁堆对象
    return 0;
}运行结果如下。
C++ 教程:对象创建
createBook() 执行完毕
已回到 main(),堆对象仍存在
C++ 教程:对象销毁
分析:
把示例 2 与示例 1 的运行结果对比一下,栈对象与堆对象的差别就非常清楚了。在示例 1 中,b1 和 b2 是栈对象,离开 readBook() 时立刻就销毁了。而在示例 2 中,new Book("C++ 教程") 将对象创建在了堆内存上。
当 createBook() 执行完毕后,堆上的 Book 对象并没有消失,它的地址返回并保存在了 main() 的指针 bookPtr 中。直到最后执行 delete bookPtr,程序才调用析构函数将其销毁。说白了,堆对象什么时候创建和销毁,完全由我们的代码决定。
指针变量与堆对象的区别
在使用堆内存时,初学者最容易搞混的地方,就是把 “指针变量本身” 和 “指针指向的堆对象” 当成同一个东西。实际上,当我们在函数里写下 Book* p = new Book("C++ 教程"); 这句代码时,内存中同时存在两个位于不同区域的部分:
- 栈上的指针变量:局部指针变量
p本身定义在函数内部,存放在栈内存上,里面只保存着一个内存地址。当函数执行结束时,p这个指针变量本身会自动销毁。 - 堆上的目标对象:通过
new创建出来的Book对象存放在堆内存上,用来保存真正的图书数据。即使栈上的局部指针p随函数结束销毁了,堆上的Book对象依然留在原地,不会跟着自动释放。
正因为这两者的生命周期彼此独立,一旦配合不当就会引发两类常见问题。如果局部指针已经随函数销毁,却忘记释放堆对象,就会造成内存泄漏。反过来,如果堆对象已经销毁了,原本指向它的指针就会变成悬空指针,继续解引用访问会导致程序异常。
比如下面这两种写法都是错误的:
void leakDemo() {
    int* p = new int(10);
}                               // 漏写 delete

void danglingDemo() {
    int* p = new int(10);
    delete p;                   // 堆对象已销毁
    std::cout << *p << "\n";    // 访问已释放内存
}
注意 局部指针离开作用域销毁时,并不会自动释放它指向的堆对象;反过来,执行 delete 销毁堆对象后,原指针变量里依然留着旧地址,也不会自动变为空指针。
栈内存与堆内存对比
前面我们分别了解了栈内存和堆内存的工作方式,它们之间的主要区别如下表所示。
| 对比维度 | 栈内存(Stack) | 堆内存(Heap) |
|---|---|---|
| 存放内容 | 函数参数、普通局部变量、局部对象 | 通过 new 或智能指针动态创建的对象 |
| 管理方式 | 编译器自动分配、自动释放 | 手动释放,或交由智能指针自动管理 |
| 生命周期 | 进入作用域创建,离开作用域自动销毁 | 从动态创建开始,直到显式释放才销毁 |
| 空间与效率 | 分配速度非常快,可用空间较小(通常几 MB) | 分配速度相对较慢,可用空间很大 |
| 常见风险 | 超大局部数据或无限递归会导致栈溢出 | 忘记释放会内存泄漏,释放后误用会产生悬空指针 |
在实际开发中,看到堆内存空间大、存活时间又自由,有些小伙伴可能会想把所有对象都放到堆上。其实恰恰相反,只要普通的栈对象能够满足需求,我们都应该优先使用栈对象。
一方面,栈内存按顺序直接分配和回收,运行速度更快;另一方面,栈对象离开作用域就会自动销毁,不用担心漏写释放代码。
只有当对象确实需要跨函数存活,或者数据体积很大、需要避免栈溢出时,我们才考虑把数据放到堆上。而且在现代 C++ 开发中,即使需要使用堆内存,我们通常也会优先借助 std::vector 或智能指针来自动管理,尽量减少手写 new 和 delete。
常见问题
1. 局部变量离开函数就会销毁,为什么平时写 return sum 返回局部变量的值却不会出错?
因为 return sum; 执行的是 “按值返回”。在局部变量 sum 销毁之前,编译器已经把 sum 里的数值复制了一份交给调用者,后续原变量销毁并不会影响外部拿到的副本。
真正不能返回的是栈上局部变量的指针(如 return &sum)或引用,因为那样传出去的是栈内存地址,函数一结束那块空间就已经失效了。
2. 如果在函数里定义超大局部数组发生了栈溢出,应该怎么解决?
最推荐的做法是改用 std::vector<int> arr(10000000)。arr 这个容器对象本身在栈上只占几十个字节,而内部真正用来存放一千万个整数的连续空间是在堆内存上动态分配的,既不会撑爆栈空间,离开函数时又会自动释放内存。
