



在 C++ 中,std::list 是标准库提供的 “双向链表” 容器,它的内部组织方式和 std::vector 完全不同。
vector 把所有元素紧挨着排在一整块连续内存里,就像剧场里一排带有固定编号的座位。而 list 里的元素则像一排手拉手站在一起的人,每个节点除了保存数据本身,只记录自己 “前面是谁、后面是谁”,并不要求在内存里紧挨着存放,如下图所示。
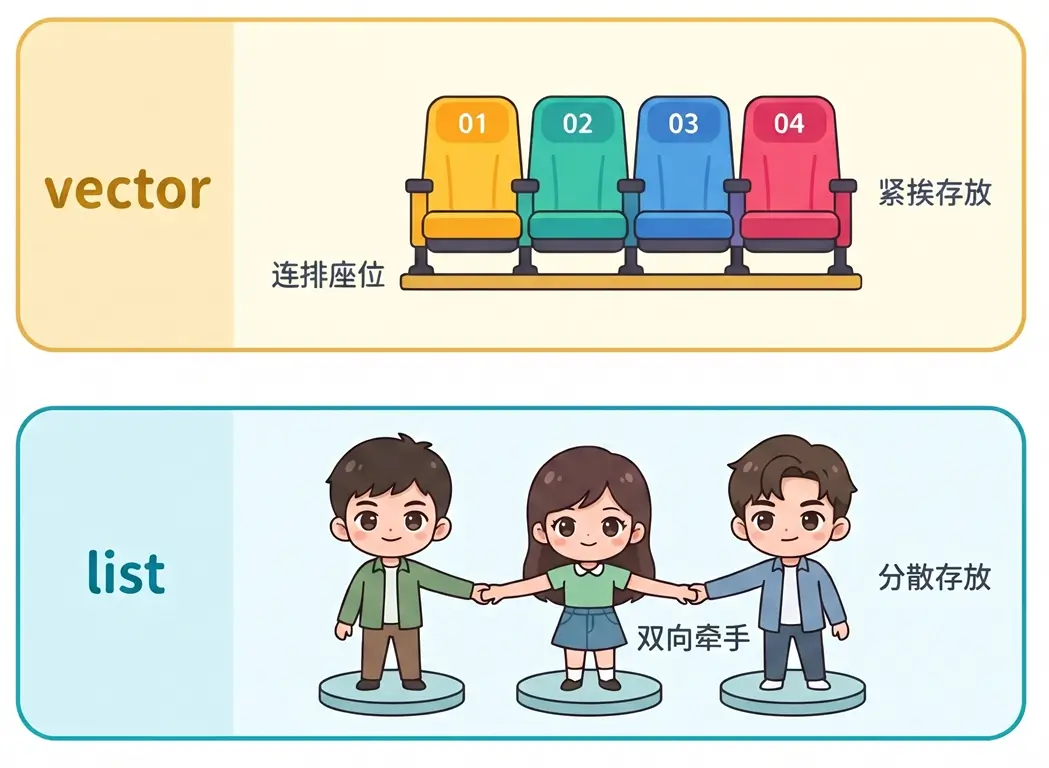
对于 std::list 来说,这种链表结构带来了两个鲜明的特点:
- 已知位置插删快:只要已经拿到了某个节点的位置,在它旁边插入或删除元素时,只需要断开并重新连接相邻节点即可,不用挪动其他元素。
- 不支持下标访问:因为节点在内存中分散存放、没有连续的位置编号,所以不能使用下标
[]直接跳到第几个元素,只能顺着链条从头或从尾一步步往后找。
C++ list 的创建与遍历
std::list 定义在 <list> 头文件中,用来保存数量可动态变化、类型相同的一组元素。
语法:
#include <list>

std::list<元素类型> 变量名 = {元素1, 元素2, ...};
说明:
std::list 的初始化写法与 vector、std::deque 相同,可以直接使用花括号给出初始元素。如果不写初始值,则会创建一个空链表。std::list 常用的成员函数如下表所示。
| 操作写法 | 功能说明 |
|---|---|
| lst.front() / lst.back() | 访问链表头部元素 / 访问链表尾部元素 |
| lst.push_front(x) | 将元素 x 添加到链表头部 |
| lst.push_back(x) | 将元素 x 添加到链表尾部 |
| lst.pop_front() / lst.pop_back() | 删除链表头部元素 / 删除链表尾部元素 |
| lst.insert(pos, x) | 在迭代器 pos 指向的位置之前插入元素 x |
| lst.erase(pos) | 删除迭代器 pos 指向位置上的元素 |
| lst.remove(val) | 删除链表中所有值等于 val 的元素 |
| lst.sort() / lst.reverse() | 将链表元素升序排序 / 将链表元素首尾反转 |
| lst.clear() | 清空链表中的所有元素 |
| lst.size() | 返回当前元素的个数 |
| lst.empty() | 判断链表是否为空,为空返回 true |
示例 1:创建与首尾添加元素
#include <iostream>
#include <list>
#include <string>

int main() {
    std::list<std::string> langs = {"C++", "Python"};

    langs.push_front("C");    // 在头部添加元素
    langs.push_back("Go");    // 在尾部添加元素

    std::cout << langs.size() << '\n';
    std::cout << langs.front() << ' ' << langs.back() << '\n';

    for (const std::string& lang : langs) {
        std::cout << lang << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
4
C Go
C C++ Python Go
分析:
在这个例子中,langs.push_front("C"); 把 "C" 插入到链表最前面,langs.push_back("Go"); 把 "Go" 追加到最后面,元素个数变为 4。随后我们通过 front() 和 back() 读取首尾元素,再配合范围 for 循环顺着节点的连接关系依次输出全部元素。
需要特别注意的是,std::list 既没有提供 [] 下标运算符,也没有提供 at() 函数。如果我们尝试按位置编号直接读取元素,编译时就会直接报错:
std::list<int> nums = {10, 20, 30};
std::cout << nums[1] << '\n';    // 不支持 [] 下标访问
在指定位置插入和删除元素
std::list 最擅长的是在某个已经确定的节点附近插入或删除元素。由于不能使用数字下标来表示位置,这里我们需要借助迭代器来指向链表中的节点。
关于迭代器我们会在下一章展开介绍,现在小伙伴们可以先结合前面学过的指针来理解,把它看作 “指向容器元素的定位器”:使用 ++pos 表示顺着链表往后走一步,使用 *pos 表示取出当前节点里的值。
1. 在指定位置前插入元素:insert()
在 C++ 中,调用 insert() 成员函数,可以在迭代器指定的位置之前插入一个新元素。
语法:
链表名.insert(位置迭代器, 新元素);说明:
我们可以通过 lst.begin() 拿到指向第一个元素的迭代器。因为链表节点在内存里不是连续排列的,所以 list 的迭代器不支持 pos + 2 这种直接跨越多步的算术加法,只能使用 ++pos 顺着链条向后走一步,或使用 --pos 向前退一步:
// 正确方式
++pos;

// 错误方式
pos = pos + 2;
示例 2:在指定位置前插入元素
#include <iostream>
#include <list>
#include <string>

int main() {
    std::list<std::string> langs = {"C", "Python", "Go"};

    auto pos = langs.begin();    // 指向第一个元素
    ++pos;                       // 后移指向第二个元素
    langs.insert(pos, "C++");    // 在当前位置前插入

    for (const std::string& lang : langs) {
        std::cout << lang << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
C C++ Python Go分析:
上面代码中,auto pos = langs.begin(); 先让迭代器 pos 指向第一个元素 "C"。接着执行 ++pos; 后,pos 顺着链表向后走了一步,停在第二个元素 "Python" 的位置上。
随后调用 langs.insert(pos, "C++");,就会把 "C++" 插入到 pos 当前指向的 "Python" 前面。整个插入过程只需要修改相邻节点之间的连接关系,不需要像 vector 那样把后面的元素在内存里往后搬动。
2. 删除元素:erase() 与 remove()
如果要删除 list 中的元素,除了删首尾的 pop_front() 和 pop_back() 之外,常用的还有 2 种方式:① 调用 erase() 删除指定位置上的节点;② 调用 remove() 直接按元素值删除。
语法:
链表名.erase(位置迭代器);
链表名.remove(元素值);
说明:
当我们手里已经有了指向目标节点的迭代器时,调用 erase(pos) 可以直接把该位置的节点删掉。如果只是想把链表里所有等于某个特定值的元素统统删掉,不想手动移动迭代器去找位置,直接调用 std::list 自带的 remove(val) 会省事得多。
示例 3:删除 list 中的元素
#include <iostream>
#include <list>

int main() {
    std::list<int> nums = {10, 99, 20, 30, 20};

    auto pos = nums.begin();
    ++pos;
    nums.erase(pos);    // 删除第二个元素 99

    nums.remove(20);    // 按值删除所有的 20

    for (int n : nums) {
        std::cout << n << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
10 30分析:
nums.erase(pos); 这句代码表示把 pos 指向的第二个元素 99 从链表中拆掉并销毁。这里我们要特别注意,这个节点一旦被删除,原来指着它的迭代器 pos 就像指着一间已经拆掉的空房子一样,立刻就失效了,千万不能再对它执行 *pos 读取或 ++pos 移动。
如果在删除节点后还需要接着处理后面的元素,我们可以写成 pos = nums.erase(pos);,用 pos 重新接住 erase() 返回的 “下一个有效节点位置”。紧接着调用的 nums.remove(20); 则会自动扫描整条链表,把所有值等于 20 的节点全部移除,最终只剩下 10 和 30。
连续内存与链表节点的访问效率
很多初学的小伙伴容易死记一句 “中间插入和删除多就选择 list”,其实这个说法并不完整。list 真正快的是 “已经拿到节点位置之后” 的插入和删除。如果每次操作前都要先按 “第 N 个元素” 从头一步步走过去找位置,那么找位置本身就会花掉不少时间。
此外,std::vector 的所有元素紧挨在一块连续内存中,现代 CPU 读取连续内存的速度远快于读取分散在各处的链表节点。因此在实际开发中,除非确定需要在已知位置频繁插删大量数据,否则默认还是优先选择 std::vector。
list 的排序与反转:sort() 和 reverse()
在使用 std::list 时,有一个初学者很容易踩坑的地方:我们不能把 std::list 的起止迭代器传给 <algorithm> 头文件里的通用 std::sort() 函数。
为什么不行呢?因为通用算法 std::sort() 在排序时需要频繁按位置编号折半跳转,而双向链表 std::list 的节点没有连续编号,只能顺着链条一步步走。为了解决这个问题,std::list 专门自带了成员函数 sort() 和 reverse(),直接通过调整节点的连接顺序来完成排序和反转。
示例 4:排序与反转 list
#include <iostream>
#include <list>

int main() {
    std::list<int> nums = {40, 10, 50, 20, 30};

    nums.sort();       // 默认按从小到大排序
    for (int n : nums) {
        std::cout << n << ' ';
    }
    std::cout << '\n';

    nums.reverse();    // 将元素首尾反转
    for (int n : nums) {
        std::cout << n << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
10 20 30 40 50
50 40 30 20 10
分析:
上面这个例子通过成员函数完成了排序与反转。nums.sort() 直接在链表内部重新连接各个节点,将元素按从小到大的顺序排成 10 20 30 40 50。紧接着调用 nums.reverse() 将整条链表原地首尾倒过来,变成了从大到小的 50 40 30 20 10。
如果一开始就希望直接按从大到小降序排列,也可以引入 <functional> 头文件,写成 nums.sort(std::greater<int>());。平时对 std::list 排序时,大家一定要分清成员函数 nums.sort() 与通用函数 std::sort() 的区别:
// 正确方式
nums.sort();

// 错误方式
std::sort(nums.begin(), nums.end());
vector、deque 与 list 的区别
std::vector、std::deque 和 std::list 是 STL 中最常用的 3 个动态序列容器。在实际开发中,我们可以按下面 3 种场景来选择:
- std::vector:大多数日常动态序列的默认首选。只要主要操作是在尾部追加、按顺序遍历或按下标
[]读取,凭借连续内存的优势,它的读写效率最高。 - std::deque:适合经常在头部和尾部两端增删元素、同时又需要通过下标
[]随机访问的场景,比如实现双端排队列表。 - std::list:适合顺着序列边遍历边在当前已知位置附近频繁插入或删除节点、且不需要按数字下标访问的场景。
