



在日常开发中,我们经常需要检查用户输入的手机号是不是 11 位纯数字,或者从一段运行日志里挑出所有的日期。这类需求有一个共同特点:我们只知道文本的 “格式规律”,事先并不知道具体的字符内容。
前面学过的 find() 函数适合查找 "C++"、"apple" 这类固定不变的文本,遇到按规律匹配的需求就很难应付了。在 C++ 中,我们可以借助 <regex> 头文件提供的 “正则表达式(Regular Expression)”,使用简短的规则符号描述文本特征,快速完成格式校验、子串提取和批量替换。
C++ 正则表达式基础
简单来说,正则表达式就是一套用来描述字符规律的 “匹配模板”。比如在正则规则里,\d 表示任意一个数字字符,{6} 表示连续出现 6 次,合起来写成 \d{6} 就能匹配任意 6 位连续数字。
日常处理文本时,小伙伴们不需要把所有正则符号一次性背熟,先掌握下面这几个高频匹配符号就足够应付大多数场景了,如下表所示。
| 符号 | 匹配规则 | 示例说明 |
|---|---|---|
| . | 匹配除换行符外的任意单个字符 | a.c 可匹配 "abc"、"a1c" |
| \d | 匹配任意一个数字字符(0~9) | \d\d 可匹配 "18"、"05" |
| \w | 匹配英文字母、数字或下划线 | \w+ 可匹配 "user_01" |
| \s | 匹配空格、制表符等空白字符 | a\sb 可匹配 "a b" |
| [a-z] | 匹配方括号范围内的任意单个字符 | [0-9a-f] 可匹配单个十六进制字符 |
| + / * / ? | 前一项出现 1 次或多次 / 0 次或多次 / 0 次或 1 次 | \d+ 可匹配一串连续数字 |
| {n} / {m,n} | 前一项恰好出现 n 次 / 出现 m 到 n 次 | \d{6} 可匹配 6 位连续数字 |
需要注意上表第 1 行的点号(.):它在正则规则里代表任意单个字符。如果我们想匹配网址或小数里真正的点号本身,就需要在前面加上反斜杠写成 \.,比如 \d+\.\d+ 可以用来匹配简单的小数。
在 C++ 中,使用正则表达式之前需要先通过 #include <regex> 引入头文件,再使用 std::regex 定义一个正则规则对象。
语法:
std::regex pattern(R"(正则规则)");说明:
观察上面的语法,正则规则外面套了一层 R"(...)" 原始字符串。为什么要这样写呢?因为正则规则里经常出现 \d、\. 等带反斜杠的符号。
如果直接写在普通双引号字符串里,反斜杠会被当成转义字符的开头,每个反斜杠都必须连写两个写成 "\\d"。一旦规则变长,成串的反斜杠很容易看走眼。
改用 C++11 提供的 R"(...)" 原始字符串之后,括号内部的所有字符都会按原样保留,不再需要额外转义。对于表示 “6 位数字” 的正则规则来说,下面 2 种方式是等价的。
// 方式 1(推荐)
std::regex pattern(R"(\d{6})");

// 方式 2
std::regex pattern("\\d{6}");
在实际开发中编写正则表达式时,我们更推荐使用方式 1,规则清晰直观,也不容易漏写反斜杠。
注意 定义 std::regex 时,正则规则里的小括号或中括号必须成对闭合。如果漏写了右括号,代码在编译阶段虽然不会报错,但程序运行时会直接报错并停止运行。
整串格式校验:regex_match()
在 C++ 中,如果我们想检查用户输入的验证码、手机号或日期格式是否合格,也就是判断 “整个字符串从头到尾” 是否完全符合规则,可以使用 std::regex_match() 函数。
语法:
std::regex_match(str, pattern)说明:
其中,str 是待检查的字符串,pattern 是定义好的 std::regex 正则对象。只有当整个 str 从第一个字符到最后一个字符都符合规则时,该函数才会返回 true;只要有一处不符合,就会返回 false。
示例 1:校验 6 位数字验证码
#include <iostream>
#include <regex>
#include <string>

int main() {
    std::regex codeRule(R"(\d{6})");
    std::string input1 = "839201";
    std::string input2 = "83a201";

    if (std::regex_match(input1, codeRule)) {
        std::cout << input1 << ":格式正确\n";
    }

    if (!std::regex_match(input2, codeRule)) {
        std::cout << input2 << ":格式不正确\n";
    }
    return 0;
}运行结果如下。
839201:格式正确
83a201:格式不正确
分析:
在这个例子中,codeRule 定义了 R"(\d{6})" 规则,要求文本必须恰好由 6 个数字字符组成。input1 是 6 位纯数字,完全符合规则,因此返回 true。而 input2 中间混入了字母 'a',校验不通过并返回 false。
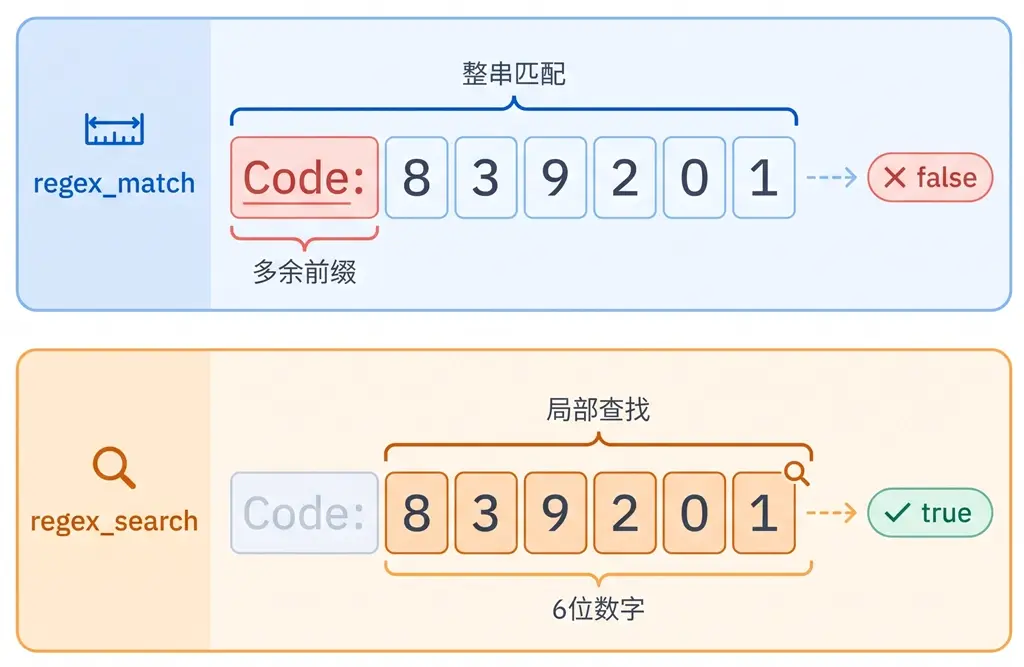
使用 std::regex_match() 时,小伙伴们要特别分清一点:它要求的是 “整串完全匹配”,而不是 “局部包含”。哪怕字符串中间有一段 6 位数字,只要前后多出了其他字符,结果依然是 false。下面这段代码的匹配结果就是 false。
std::regex codeRule(R"(\d{6})");
std::string text = "Code: 839201";
bool ok = std::regex_match(text, codeRule);    // 返回 false
上面的 text 开头带有 "Code: ",整串并不是 6 个纯数字,因此返回 false。如果我们只想在一段长文本里检查 “是否包含” 符合规律的片段,就应该使用下面介绍的 std::regex_search(),两者的区别如下图所示。
子串查找与提取:regex_search()
当我们需要从一段长文本中找出符合规则的片段,并把匹配到的具体内容提取出来时,可以使用 std::regex_search() 函数。
1. 查找首个匹配子串
调用 std::regex_search() 时,我们可以额外传入一个 std::smatch 类型的结果对象,用来保存匹配到的具体文本和位置。
语法:
std::regex_search(str, match, pattern)说明:
其中,smatch 是英文 “string match(字符串匹配)” 的缩写,专门用来保存 std::string 字符串的匹配结果。该函数接收以下 3 个参数:
- str(必选):待查找的
std::string字符串变量。 - match(必选):用来接收匹配结果的
std::smatch对象。 - pattern(必选):定义好的
std::regex正则对象。
std::regex_search() 会从左往右扫描字符串 str。一旦找到第 1 个符合规则的子串,函数就会立即返回 true 并将结果存入 match 中。随后我们可以通过 match[0] 取出匹配文本,或调用 match.position() 查看它的起始下标;如果找遍整串都没找到,则返回 false。
示例 2:提取文本中的数字编号
#include <iostream>
#include <regex>
#include <string>

int main() {
    std::string text = "ID: 202608 (paid)";
    std::regex numRule(R"(\d+)");
    std::smatch match;

    if (std::regex_search(text, match, numRule)) {
        std::cout << "提取到的数字:" << match[0] << '\n';
        std::cout << "起始下标位置:" << match.position() << '\n';
    }
    return 0;
}运行结果如下。
提取到的数字:202608
起始下标位置:4
分析:
在 "ID: 202608 (paid)" 中,开头的 "ID: " 占了 4 个字符,R"(\d+)" 从下标 4 处匹配到了连续数字 "202608"。因此 match[0] 提取出的内容是 "202608",match.position() 返回的起始下标是 4。
这里有一个初学者很容易踩坑的语法细节:配合 std::smatch 提取结果时,第 1 个参数必须传入已有的 std::string 变量,不能直接传入双引号字符串字面量。
// 正确方式
std::string text = "ID: 202608";
std::regex_search(text, match, numRule);

// 错误方式
std::regex_search("ID: 202608", match, numRule);
因为 match 内部需要记录匹配片段在原字符串中的位置,如果直接传入 "ID: 202608",临时字符串在当前语句结束后就会销毁,编译器会直接报错拦截这种写法。
2. 使用小括号分组提取
有时候,我们不仅想找到整段匹配文本,还想把里面的各个部分单独拆出来,比如从日期 "2026-10-24" 中分别提取年、月、日。这时可以在正则规则里使用英文小括号把需要单独提取的部分括起来,每一对小括号称为一个 “捕获分组”。
匹配成功后,match[0] 依然保存整段匹配文本,而 match[1]、match[2]、match[3] 则按照左小括号出现的先后顺序,依次保存第 1 个、第 2 个、第 3 个分组匹配到的子内容。
示例 3:分组提取日期中的年月日
#include <iostream>
#include <regex>
#include <string>

int main() {
    std::string log = "Date: 2026-10-24, Status: OK";
    std::regex dateRule(R"((\d{4})-(\d{2})-(\d{2}))");
    std::smatch match;

    if (std::regex_search(log, match, dateRule)) {
        std::cout << "完整日期:" << match[0] << '\n';
        std::cout << "年份:" << match[1] << '\n';
        std::cout << "月份:" << match[2] << '\n';
        std::cout << "日期:" << match[3] << '\n';
    }
    return 0;
}运行结果如下。
完整日期:2026-10-24
年份:2026
月份:10
日期:24
分析:
在 R"((\d{4})-(\d{2})-(\d{2}))" 中,最外层的 R"(...)" 属于原始字符串语法,里面的 3 对小括号 (\d{4})、(\d{2})、(\d{2}) 才是正则捕获分组,分别对应 4 位年份、2 位月份和 2 位日期。匹配成功后,通过 match[1] 到 match[3] 就能直接拿到拆好的三段数字,省去了手动计算下标截取的步骤。
3. 循环提取所有匹配项
单次调用 std::regex_search() 找到第 1 个目标后就会停下来。如果一段文本里包含多处符合规则的内容,想要把它们全部找出来,我们可以配合 while 循环逐步向后推进查找范围。
其中,std::smatch 提供了一个 suffix() 成员函数,suffix 在英文中是 “后缀、剩余部分” 的意思。每次匹配成功后,调用 match.suffix() 可以拿到当前匹配位置往后剩下的部分,接着调用 .str() 就能将它转换成普通的 std::string 字符串,供下一轮循环继续查找。
示例 4:循环提取文本中的所有数字
#include <iostream>
#include <regex>
#include <string>

int main() {
    std::string text = "C++: 95, Python: 88, SQL: 92";
    std::regex numRule(R"(\d+)");
    std::smatch match;

    std::string rest = text;
    while (std::regex_search(rest, match, numRule)) {
        std::cout << match[0] << ' ';
        rest = match.suffix().str();    // 更新为剩余未查找部分
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
95 88 92分析:
在这个例子中,我们先复制了一份副本 rest 来推进查找,避免改动原字符串 text,每一轮循环的变化过程如下:
- 第 1 次循环:从
"C++: 95, Python: 88, SQL: 92"中找到"95",rest更新为后面的", Python: 88, SQL: 92"。 - 第 2 次循环:继续从剩余文本中找到
"88",rest更新为", SQL: 92"。 - 第 3 次循环:找到最后的
"92",rest变为空字符串"",下一轮判断返回false,循环自动结束。
按规则批量替换:regex_replace()
前面学习字符串替换时,replace() 函数需要指定起始下标和字符个数,遇到位置不固定的多处目标就得手写循环逐一处理。使用 std::regex_replace() 函数,我们只需一行代码就能把字符串中所有符合正则规则的片段全部替换掉。
语法:
std::string res = std::regex_replace(str, pattern, fmt);说明:
其中,str 是原字符串,pattern 是正则对象,fmt 是准备换上去的新文本。与直接修改原变量的 str.replace() 不同,std::regex_replace() 不会修改原字符串本身,而是生成并返回替换后的新字符串。
此外,如果正则规则里定义了小括号捕获分组,我们还可以在替换文本 fmt 中使用 $1、$2 来引用第 1 个、第 2 个分组原有的内容。这在保留首尾字符、隐藏中间敏感信息时非常实用。
示例 5:合并多余空格与手机号脱敏
#include <iostream>
#include <regex>
#include <string>

int main() {
    // 1. 将连续多个空白字符合并为单个空格
    std::string raw = "Learn   C++    on   lvyenet";
    std::regex spaceRule(R"(\s+)");
    std::string clean = std::regex_replace(raw, spaceRule, " ");
    std::cout << clean << '\n';

    // 2. 隐藏手机号中间 4 位数字
    std::string phone = "13812345678";
    std::regex phoneRule(R"((\d{3})\d{4}(\d{4}))");
    std::string masked = std::regex_replace(phone, phoneRule, "$1****$2");
    std::cout << masked << '\n';
    return 0;
}运行结果如下。
Learn C++ on lvyenet
138****5678
分析:
在第 1 段替换中,R"(\s+)" 表示匹配 1 个或多个连续的空白字符。不管单词之间敲了几个空格,std::regex_replace() 都会把每一处连续空格统一替换成单个空格 " "。
在第 2 段手机号脱敏中,R"((\d{3})\d{4}(\d{4}))" 把前 3 位数字放进第 1 个分组 (\d{3}),把末尾 4 位数字放进第 2 个分组 (\d{4}),中间的 \d{4} 不加小括号。替换文本 "$1****$2" 中的 $1 和 $2 会自动填入前 3 位 "138" 和后 4 位 "5678",中间则替换为 "****",最终得到 "138****5678"。
同时小伙伴们要注意,由于 std::regex_replace() 不会修改原变量 phone 本身,调用时记得像上面那样使用变量接收返回的新字符串,或者重新赋回给 phone。
常见问题
1. 既然正则表达式这么灵活,平时查找固定子串还需要使用 string 自带的 find() 吗?
需要。std::regex 在解析正则规则和匹配文本时有额外的运行开销,处理速度比普通字符串函数慢不少。
如果只是查找固定的字符或单词,比如查找等号 '=' 或子串 "lvye",我们优先调用简单高效的 find() 即可。只有当目标没有固定写法、必须按格式规律匹配时,才使用正则表达式。
2. regex_match() 和 regex_search() 应该怎么快速区分?
平时写代码时,我们只需要看 “是否要求整个字符串从头到尾完全符合规则”:
整串格式校验:检查用户输入的验证码、手机号或日期整体合不合格时,我们使用要求全串匹配的 std::regex_match()。
局部子串查找:从一段日志或长句中判断是否存在某类内容,或提取其中的数字与日期片段时,我们使用局部查找的 std::regex_search()。
