



在 C++ 中,像 vector、list、set、map 这些 STL 容器,底层保存数据的方式各不相同。有的把元素排在连续的内存空间里,有的则像链表或树一样,把元素分散存放在不同的节点中。
如果每种容器都单独设计一套访问语法,不仅我们学起来费劲,标准库里的通用算法也没法统一处理它们。为了解决这个问题,C++ 提供了 “迭代器(iterator)”,用来给不同容器提供一套统一的 “元素位置表示方式”。
C++ 迭代器是什么?
你可以把迭代器理解成容器里的一个 “书签”。书签本身不是书里的文字,但它能准确标记当前读到了哪个位置,往后挪动一格就能接着读取下一个元素。
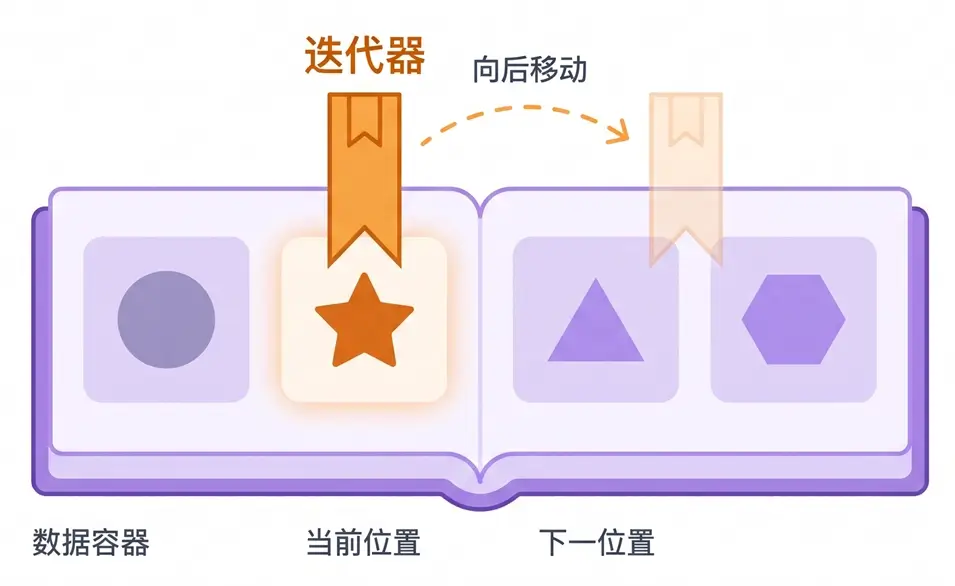
从代码写法上看,迭代器和前面学过的指针非常相似。比如我们可以通过 * 读取当前位置的元素,也可以通过 ++ 把迭代器移动到下一个位置。需要注意的是,迭代器只是 “用起来像指针”,并不代表所有容器的迭代器底层都是普通指针。
语法:
auto it = 容器.begin();
*it
++it
说明:
迭代器的基本操作主要包括以下 3 个部分:
- begin():获取容器第 1 个元素所在的位置,即起始迭代器。
- *it:解引用迭代器,用来读取或修改当前位置的元素。
- ++it:将迭代器向后移动 1 个位置,指向下一个元素。
示例 1:读取和修改元素
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {10, 20, 30};

    auto it = nums.begin();    // 指向第 1 个元素
    std::cout << *it << '\n';

    *it = 100;                 // 修改第 1 个元素的值
    std::cout << nums[0] << '\n';

    ++it;                      // 向后移动 1 个位置
    std::cout << *it << '\n';
    return 0;
}运行结果如下。
10
100
20
分析:
auto it = nums.begin(); 表示获取 nums 第 1 个元素的位置,刚开始打印 *it 得到 10。由于 *it 代表的就是该元素本身,我们执行 *it = 100; 后,nums[0] 的值就被直接修改成了 100。
接着执行 ++it;,迭代器向后移动到第 2 个元素,此时打印 *it 得到 20。这里我们使用了 auto 关键字来自动推导迭代器的类型,下面 2 种方式是等价的。
// 方式 1
std::vector<int>::iterator it = nums.begin();

// 方式 2(推荐)
auto it = nums.begin();
其中,方式 1 写出了完整的迭代器类型,而方式 2 直接交给编译器自动推导。完整的迭代器类型写起来比较繁琐,因此在实际开发中我们更推荐使用方式 2。
此外,当容器里存放的是结构体、类对象,或者像 map 容器那样存放键值对时,每个元素内部都包含自己的成员。这时除了写成 (*it).成员名,我们还可以直接使用箭头运算符 it->成员名 来访问。下面我们来看一个例子。
示例 2:使用 -> 访问元素成员
#include <iostream>
#include <map>
#include <string>

int main() {
    std::map<std::string, int> scores = {
        {"Jack", 95},
        {"Lucy", 88}
    };

    auto it = scores.begin();    // 指向第 1 个键值对
    std::cout << it->first << ":" << it->second << '\n';
    return 0;
}运行结果如下。
Jack:95分析:
scores 中的每个元素都是一组键值对,包含键 first 和值 second 两个成员。it->first 表示读取当前键值对的键,等价于写成 (*it).first。
之所以要给 *it 加上圆括号,是因为点号 . 的优先级比 * 更高。对比之下,直接使用箭头运算符 it->first 要简洁直观得多。
使用迭代器遍历容器
在 C++ 中,如果我们想从头到尾遍历整个容器,只知道起始位置 begin() 还不够,还必须知道什么时候停下来。根据遍历方向的不同,主要分为正向遍历和反向遍历两种方式。
1. 正向遍历:begin() 和 end()
正向遍历容器时,停止边界由 end() 来提供。以包含 10、20、30 这 3 个元素的容器为例,begin() 和 end() 指向的位置如下所示:
[10(begin)] -> [20] -> [30] -> [末尾后一格(end)]从上面可以看出,begin() 指向第 1 个元素 10,而 end() 指向的是 “最后一个元素 30 后面的位置”。换句话说,end() 本身并不指向任何真实存在的元素,它只是一个用来标记 “已经走到头了” 的结束边界。
我们通常使用 [begin, end) 来表示这段范围。左边的方括号([)表示包含 begin,右边的圆括号())表示不包含 end,这种左闭右开的范围称为 “半开区间”。遍历时只要 it != nums.end() 成立,程序就继续访问当前元素。
注意 end() 指向的不是最后一个元素,而是最后一个元素后面的位置。因此,小伙伴们千万不要对 end() 返回的迭代器做解引用操作(如 *nums.end()),否则会导致未定义行为,程序可能读出乱码或直接崩溃。
示例 3:正向遍历 vector
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {10, 20, 30};

    for (auto it = nums.begin(); it != nums.end(); ++it) {
        std::cout << *it << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
10 20 30分析:
在这个例子中,迭代器 it 从 nums.begin() 出发,每轮循环先打印 *it,再执行 ++it 移向下一个位置。当输出完 30 并再次后移后,it 到达 nums.end(),循环条件不再成立,遍历自然结束。
为什么 C++ 要把 end() 设计在最后一个元素的后面呢?因为这样处理 “空容器” 非常方便。当容器为空时,begin() == end(),上面的循环条件一开始就不成立。此时循环会直接执行 0 次,不需要我们额外再写 if 判断容器是否为空。
另外,如果在遍历时只希望读取元素、不允许修改元素,我们可以使用 cbegin() 和 cend()(字母 c 代表 const),写法如下:
for (auto it = nums.cbegin(); it != nums.cend(); ++it) {
    std::cout << *it << ' ';
}
cbegin() 和 cend() 返回的是只读迭代器 const_iterator。一旦我们在循环内部误写了修改元素的代码,编译器就会直接报错提醒。
2. 反向遍历:rbegin() 和 rend()
有时候我们需要从最后一个元素往前倒着遍历容器。这时可以使用容器提供的 rbegin() 和 rend(),其中前面的字母 r 是 “reverse(反向)” 的缩写。
[开头前一格(rend)] <- [10] <- [20] <- [30(rbegin)]如上所示,rbegin() 指向容器的最后一个元素 30,而 rend() 指向第 1 个元素 10 前面的结束边界。
示例 4:反向遍历 vector
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {10, 20, 30};

    for (auto it = nums.rbegin(); it != nums.rend(); ++it) {
        std::cout << *it << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
30 20 10分析:
nums.rbegin() 将最后一个元素 30 作为起点,依次朝 nums.rend() 推进。这里需要小伙伴们特别留心:反向迭代器往前倒着走一步依然是写 ++it,而不是 --it,因为它内部已经把 ++ 的方向反转成了 “从后往前移一步”。
迭代器的移动能力
虽然不同容器的迭代器都支持 *it、++it 和 != 比较,但因为各容器的底层存储结构不同,它们的迭代器在 “移动能力” 上存在明显差异。
对于初学的小伙伴来说,不需要去死记复杂的底层分类术语,只需要重点区分下表中的 3 种移动能力即可。常见容器的对应关系如下表所示。
| 容器类型 | 移动能力 | 支持的操作 | 特点说明 |
|---|---|---|---|
| vector、array、deque | 随机访问 | ++、--、it + n、it - n、it2 - it1 | 可跨步跳转,也能相减算距离 |
| list、set、map | 双向移动 | ++、-- | 只能一步步前移或后退,不能跨步 |
| unordered_set、unordered_map | 单向移动 | ++ | 只能一步步向后移动,不能后退 |
为什么要区分这些移动能力呢?因为后面学习的某些 STL 算法要求迭代器必须支持 it + n 跨步跳转,这时我们就不能把 list 或 set 的迭代器传给它。下面来看看 vector 的迭代器是如何跨步跳转和计算下标的。
示例 5:迭代器的跨步与距离计算
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums = {10, 20, 30, 40, 50};

    auto it = nums.begin();
    it = it + 3;    // 向后跳过 3 个位置
    std::cout << *it << '\n';

    --it;           // 向前退 1 个位置
    std::cout << *it << '\n';
    std::cout << (it - nums.begin()) << '\n';    // 计算当前下标
    return 0;
}运行结果如下。
40
30
2
分析:
nums.begin() 刚开始指向下标 0 处的元素 10。由于 vector 的迭代器支持随机访问,执行 it = it + 3; 后,迭代器直接向后跳了 3 个位置,指向下标 3 处的元素 40。
接着执行 --it; 往前退一步,就回到了元素 30。此时通过 it - nums.begin() 将当前迭代器与起点相减,就能直接算出它距离起点隔了 2 个位置,也就是下标 2。
需要注意的是,只有支持随机访问的迭代器才能使用 + 或 - 跨步跳转。如果我们把容器换成 list,下面这种写法就会直接编译报错。
std::list<int> nums = {10, 20, 30, 40};
auto it = nums.begin() + 2; // 编译报错下面代码中,*it 最终输出的值是 30,小伙伴们可以结合 end() 的位置思考一下为什么。
std::vector<int> nums = {10, 20, 30, 40, 50};
auto it = nums.end() - 1;
it = it - 2;
C++ 迭代器失效
在使用迭代器操作容器时,有一个初学者常遇到的坑,叫做 “迭代器失效”。所谓的迭代器失效,说白了就是当容器内部增加、删除元素或发生扩容后,原来保存的那个迭代器位置已经作废了,不能再继续使用。
1. 为什么会发生迭代器失效?
以最常用的 vector 为例,它的元素存放在一块连续的内存空间中。当出现以下 2 种情况时,原有的迭代器就会失效:
- 插入元素触发扩容:当现有空间装不下新元素时,
vector会申请一块更大的新内存把元素搬过去,并释放旧内存。这就像朋友搬了新家、老房子已经退租,拿着旧地址自然就找不到了,因此指向旧内存的所有迭代器都会失效。 - 删除或插入中间元素:当删除某个元素时,被删位置后面的所有元素都会往前挪动一格来填补空缺,因此被删位置及其后面的迭代器都会失效。
如果我们需要在循环遍历中调用 erase() 按条件删除元素,千万不要在删除后继续对旧迭代器执行 ++it。正确的做法是通过 erase() 的返回值更新迭代器,它会返回指向 “被删元素下一个有效元素” 的新位置。请看下面例子。
示例 6:循环中安全删除元素
#include <iostream>
#include <vector>

int main() {
    std::vector<int> scores = {75, 50, 45, 85};

    for (auto it = scores.begin(); it != scores.end(); ) {
        if (*it < 60) {
            it = scores.erase(it);    // 删除并接收下一个有效位置
        } else {
            ++it;                     // 不删除时才手动后移
        }
    }

    for (int s : scores) {
        std::cout << s << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
75 85分析:
在这个例子中,我们要把低于 60 分的成绩删掉,并且特意放了连续两个不及格分数 50 和 45。注意 for 循环小括号的最后一部分留空了,没有像平时那样写 ++it。
当检查到 50 小于 60 时,scores.erase(it) 会把 50 删掉,后面的 45 和 85 自动前移补位,原来的 it 随之失效。我们用 it 接收 erase() 返回的新位置,它刚好指向替补上来的 45,下一轮就能紧接着检查 45。
反过来想,如果我们删除后还惯性执行一次 ++it,不仅会对失效迭代器违规操作,还会直接跳过并漏删紧挨着的 45。因此,只有当元素不需要删除时,我们才在 else 分支里手动执行 ++it; 往后走一步。
2. 常见容器的迭代器失效规律
不同容器的底层结构不同,它们在插入或删除元素时的迭代器失效规则也不一样。大家不需要死记硬背复杂的细节,先掌握下面 3 条常见规律即可:
- vector:一旦因为添加元素触发了扩容,所有已有的迭代器全部失效。即使没有触发扩容,
insert()或erase()也会导致修改位置及其后面的迭代器失效。 - deque:在头部或尾部增删元素可能导致迭代器失效,在中间插入或删除元素则会使所有迭代器失效。
- list、set 和 map:由于底层是链表或树节点结构,插入新元素不会让已有迭代器失效。删除元素时,只有指向 “被删除元素” 的那个迭代器会失效,其他位置的迭代器不受影响。
在日常写代码时,只要我们对容器执行了 push_back()、insert()、erase() 等可能改变容器结构的操作,就不要再继续使用之前保存的旧迭代器,而是重新获取或用返回值更新后再使用。
常见问题
1. 有了范围 for 循环,为什么还需要学习迭代器?
如果只是把容器里的每个元素从头到尾读一遍,优先使用前面学过的范围 for 循环会更简单直观。但在下面这 3 种常见场景中,范围 for 循环就帮不上忙了,我们必须使用迭代器:
配合 STL 算法处理数据:大多数标准库算法都需要传入 begin() 和 end() 这样的一对迭代器来指定处理范围。
按位置插入或删除元素:容器的 insert()、erase() 等方法需要传入迭代器指明操作位置,而且我们不能在范围 for 循环内部直接增删容器元素。
接收查找结果或遍历子区间:在容器中查找元素时,查找函数通常会返回指向目标位置的迭代器。如果我们只想遍历容器中间的一部分元素,也需要借助迭代器控制起止边界。
2. 遍历容器时,++it 和 it++ 有什么区别?
在循环中写成 ++it 和 it++,最终移动到的位置是一样的。不过迭代器通常是封装好的类对象,后置的 it++ 需要先额外复制一份旧位置的临时对象再移动。而前置的 ++it 直接原地后移,没有多余的复制开销,平时更推荐养成写 ++it 的习惯。
