



如果我们在处理数据时只需要自动过滤重复项、快速判断某个值存不存在,并不关心元素按什么顺序排列,就可以使用 C++ 标准库提供的无序集合 std::unordered_set。
从英文名字上就很容易记住:unordered 是 “无序” 的意思,加上 set(集合),合起来就是 “无序集合”。它和 std::set 一样保证元素不会重复,但底层采用 “哈希表” 来组织数据,省去了维护大小排序的开销,平均查找速度更快。
unordered_set 的创建与遍历
使用 std::unordered_set 需要先引入 <unordered_set> 头文件,用来保存类型相同、彼此唯一的一组元素。
语法:
#include <unordered_set>

std::unordered_set<元素类型> 变量名 = {元素1, 元素2, ...};
说明:
初始化时如果放入了重复元素,容器会自动去重,只保留一份。可能有些小伙伴会感到好奇:“什么是哈希表?为什么它叫无序集合呢?”
哈希表就相当于一排 “根据元素内容直接算出格子编号的储物柜”。存放和查找元素时,容器不需要像 std::set 那样把元素挨个拿出来比大小,而是根据元素的值直接算出它应该放在几号格子里,一步就能定位到目标位置。
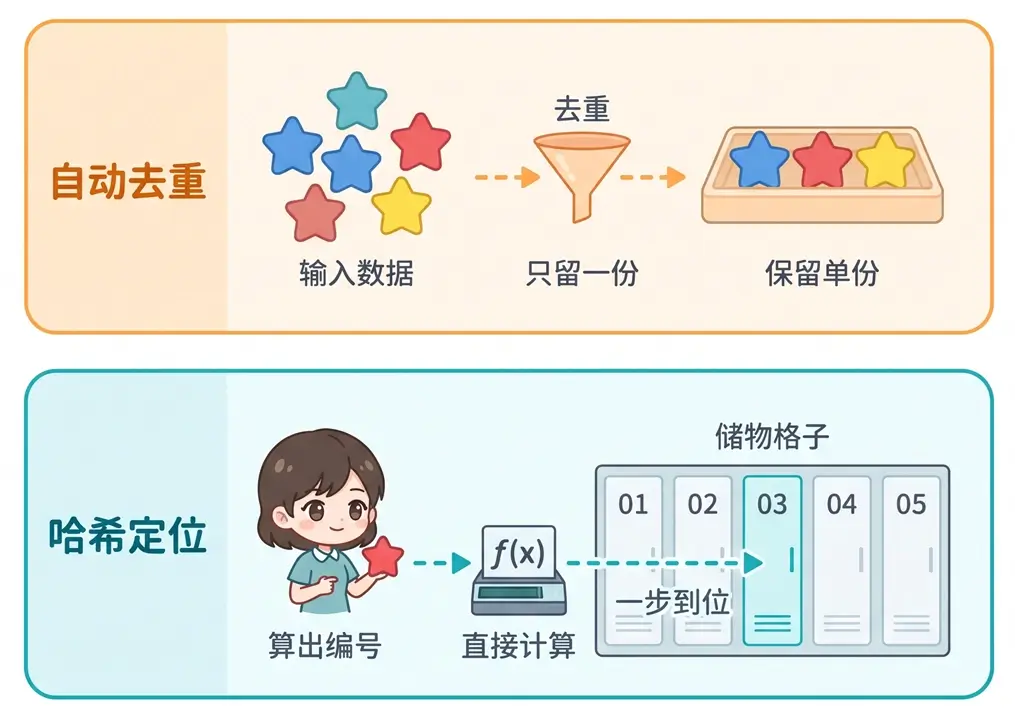
正因为每个元素放进哪个格子是由哈希计算决定的,所以容器内部既不按从小到大排列,也不按插入的先后顺序排列。std::unordered_set 的常用成员函数如下表所示。
| 操作写法 | 功能说明 |
|---|---|
| us.insert(x) | 向集合中插入元素 x,如果已存在则自动忽略 |
| us.contains(x) | 判断元素 x 是否存在,返回 true 或 false |
| us.find(x) | 查找元素 x 所在的位置,找不到则返回 us.end() |
| us.erase(x) | 按元素值删除集合中的指定元素 |
| us.clear() | 清空集合中的所有元素 |
| us.size() | 返回当前元素的个数 |
| us.empty() | 判断集合是否为空,为空返回 true |
示例 1:创建并遍历无序集合
#include <iostream>
#include <unordered_set>

int main() {
    // 放入含重复项的编号
    std::unordered_set<int> ids = {105, 102, 108, 102, 105};

    std::cout << ids.size() << '\n';
    for (int id : ids) {
        std::cout << id << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
3
108 102 105
分析:
从运行结果可以看出,初始化 ids 时放入了重复的 102 和 105,容器会自动将重复项过滤掉,因此 ids.size() 的结果是 3。同时可以看到,遍历输出的结果既不是从小到大的 102 105 108,也不是放入时的先后顺序 105 102 108。
提示 在不同编译器、不同运行环境,或者往容器里继续插入新元素后,unordered_set 遍历打印出来的顺序都可能发生变化。因此,小伙伴们平时写代码时千万不要依赖它的遍历顺序。
插入、查找与删除元素
在 C++ 中,std::unordered_set 的增删查函数在名称和调用方式上跟 std::set 完全一致。
语法:
集合名.insert(元素);
集合名.contains(要查找的值);
集合名.erase(要删除的值);
说明:
判断某个值在不在集合里时,直接调用 contains() 即可返回 true 或 false。另外,unordered_set 中的元素同样是只读的,不能通过迭代器原地修改。如果需要替换某个元素,依然先调用 erase() 删除旧值,再调用 insert() 插入新值。
示例 2:插入、查找与删除元素
#include <iostream>
#include <string>
#include <unordered_set>

int main() {
    std::unordered_set<std::string> fruits = {"apple", "banana"};

    fruits.insert("orange");       // 插入新元素
    fruits.insert("apple");        // 重复元素自动忽略
    std::cout << "插入后个数:" << fruits.size() << '\n';

    if (fruits.contains("banana")) {
        fruits.erase("banana");    // 按值删除元素
    }

    if (!fruits.contains("banana")) {
        std::cout << "banana 已删除,剩余个数:" << fruits.size() << '\n';
    }
    return 0;
}运行结果如下。
插入后个数:3
banana 已删除,剩余个数:2
分析:
上面代码中,fruits.insert("orange"); 把新元素加入了集合,而紧接着的 fruits.insert("apple"); 因为元素已存在会被自动忽略,所以插入后元素个数变为 3。
随后我们通过 fruits.contains("banana") 确认目标存在,并调用 erase() 将其移除。再次查询时就已经找不到 "banana" 了,剩余元素个数变为 2。
使用 unordered_set 过滤重复数据
在实际开发中,我们经常会遇到这样一个需求:手头有一个 std::vector 动态数组,里面混有一些重复数据,希望把重复项去掉,同时还要严格保留每个元素第一次出现时的先后顺序。
如果直接把数据全部放进 std::set,虽然能去重,但顺序会被改成从小到大。如果直接放进 std::unordered_set 遍历,原来的先后顺序也会被打乱。这时候,最实用的做法就是把 unordered_set 当作一张 “已出现元素登记表”,边遍历数组边查表过滤。下面我们来看这个例子。
示例 3:保留原序过滤重复元素
#include <iostream>
#include <unordered_set>
#include <vector>

int main() {
    std::vector<int> nums = {30, 10, 20, 10, 40, 30};
    std::vector<int> result;
    std::unordered_set<int> seen;

    for (int n : nums) {
        if (!seen.contains(n)) {    // 未出现过则登记并保留
            seen.insert(n);
            result.push_back(n);
        }
    }

    for (int n : result) {
        std::cout << n << ' ';
    }
    std::cout << '\n';
    return 0;
}运行结果如下。
30 10 20 40分析:
在这个例子中,seen 是一个用来登记 “哪些数字已经出现过” 的无序集合。当我们使用范围 for 循环依次读取原数组 nums 中的数字时,比如第一次遇到 30,!seen.contains(30) 条件成立,程序就会把 30 登记到 seen 中,并追加到结果数组 result 的末尾。
等后面第二次再遇到 30 时,因为 seen 里已经有记录了,seen.contains(30) 返回 true,if 条件不成立,程序就会直接跳过它。这样既利用了 unordered_set 查找快的特点,又完整保留了 30 10 20 40 原本的出场顺序。
unordered_set 与 set 的区别
在实际开发中,std::set 和 std::unordered_set 都用于元素去重与快速查找。如果去重之后还需要按从小到大的顺序遍历数据,比如按序输出不重复的学号或日期,直接选择 std::set 会更省心。
如果大家不关心遍历顺序,只想知道 “某个值有没有出现过”,比如记录已签到的用户编号、过滤已访问的网址,那么优先选择查找速度更快的 std::unordered_set。
另外还要留意,C++ 标准库默认为 int、double、std::string 等常见类型内置了哈希规则,但没有为 std::pair 或自定义结构体提供默认哈希函数。如果要对成对的坐标数据去重又不想手动编写哈希规则,使用按大小比较的 std::set 会更方便。
当然了,如果数据本身允许重复,或者需要按下标 [] 访问指定位置的元素,那就不需要使用集合容器,继续使用 std::vector 即可。
