



在 Go 语言中,双引号("")用来表示字符串,而单引号('')则专门用来表示 “单个字符”,比如 'A' 或 '中'。如果我们直接把单引号括起来的字符打印出来,会发生什么呢?先来看下面两行代码:
fmt.Println('A')     // 输出:65
fmt.Println('中')    // 输出:20013
明明写的是字符 'A' 和 '中',为什么打印出来的却是数字 65 和 20013 呢?
这是因为计算机底层只认识数字,所以给每一个字符都分配了一个整数编号,称为 “字符编码”。Go 语言提供了 byte 和 rune 这两种数据类型来保存单个字符的编码。
Go byte 类型
在 Go 语言中,byte 是英文单词 “字节” 的意思。它并不是一个全新的底层类型,本质上就是无符号 8 位整数 uint8 的类型别名,在内存中占 1 个字节,取值范围为 0 ~ 255。
因为英文字母、数字和常见的英文标点加起来只有一百多个,1 个字节的 ASCII 编码就足够装下了,所以 byte 类型专门用来表示单个 ASCII 英文字符。
语法:
var 变量名 byte = '字符'说明:
定义单个字符时,我们必须使用英文单引号('')把字符括起来。需要注意,如果对单引号字符直接使用 := 短变量声明,编译器默认会将其推断为 rune 类型。因此想要定义 byte 变量时,我们需要显式写出 byte 类型名。
由于 byte 本质上是整数类型 uint8,直接使用 fmt.Println() 打印时,默认输出的是该字符对应的 ASCII 数字编号。如果想要在屏幕上打印出字符本身的样子,我们可以使用 fmt.Printf() 并配合 %c 占位符。
示例 1:定义并打印 byte 字符
package main

import "fmt"

func main() {
    var ch1 byte = 'A'                 // 大写字母 A
    var ch2 byte = 'a'                 // 小写字母 a

    fmt.Println(ch1, ch2)              // 打印整数编码
    fmt.Printf("%c %c\n", ch1, ch2)    // 按字符原样打印
}运行结果如下。
65 97
A a
分析:
fmt.Println(ch1, ch2) 直接打印出了字符背后的十进制 ASCII 编码值,其中大写字母 'A' 对应 65,小写字母 'a' 对应 97。
第 2 行打印语句使用了 %c 占位符,其中 c 是 “character(字符)” 的缩写,表示把整数编号还原成对应的字符显示出来,因此输出了 A a。
提示: 在 ASCII 编码表中,有 3 个常见的起始编号:数字字符 '0' 是 48,大写字母 'A' 是 65,小写字母 'a' 是 97。其中,同一个字母的小写编码比大写大 32。这些数字不需要死记硬背,需要时随时打印查看即可。
Go rune 类型
1 个 byte 最大只能表示到 255,用来装英文字符足够了。但全世界有几万个中文汉字、日韩文字以及各种表情符号(Emoji),1 个字节根本装不下。
为了表示全世界所有的文字,Go 语言提供了第 2 种字符类型:rune。rune 在英文中是 “符文” 的意思,Go 语言借用它来表示一个完整的 Unicode 字符。
rune 本质上是有符号 32 位整数 int32 的类型别名,在内存中占 4 个字节,足以装下世界上任何一种语言的单个字符。
语法:
// 方式 1
var 变量名 rune = '字符'

// 方式 2(推荐)
变量名 := '字符'
说明:
在 Go 语言中,只要我们使用 := 短变量声明一个单引号字符,编译器默认都会将它推断为 rune(即 int32)类型。不管是英文字符 'A' 还是中文字符 '国' 都是如此,这样可以确保装下任意字符。
示例 2:定义并打印 rune 字符
package main

import "fmt"

func main() {
    var r1 rune = '国'               // 指定为 rune 类型
    r2 := '家'                       // 自动推断为 rune 类型

    fmt.Println(r1, r2)              // 打印十进制编码
    fmt.Printf("%c %c\n", r1, r2)    // 打印字符本身
    fmt.Printf("%T\n", r2)           // 查看底层类型
}运行结果如下。
22269 23478
国 家
int32
分析:
第 1 行 fmt.Println(r1, r2) 打印出了汉字 '国' 和 '家' 的 Unicode 编号(22269 和 23478)。这两个数值都已经远远超出了 byte(0 ~ 255)能容纳的范围,因此必须使用 rune 类型保存。
如果我们尝试把中文字符赋值给 byte 类型的变量,下面这种写法在编译时就会直接报错。
var c byte = '国'编译上面这行代码会提示 constant 22269 overflows byte,意思是常量 22269 超出了 byte 的取值范围。此外,通过第 3 行的 %T 打印 r2 的类型可以看到结果是 int32,这也验证了 rune 本质上就是 int32 的别名。
注意: 单引号('')内部有且只能放单个字符,比如 'a' 或 '中'。我们既不能写成没有任何字符的空单引号 '',也不能放入 'ab' 这样两个及以上的字符,否则编译器都会报错。
byte 与 rune 的区别与使用
学到这里,初学的小伙伴很容易把 string、byte 和 rune 搞混。其实我们只需要理清以下 3 点区别,如下图所示:
- 双引号字符串(string):使用双引号("")括起来,里面可以放 0 个、1 个或多个字符,代表一段文本。
- 单字节字符(byte):使用单引号('')括起来,等同于
uint8,固定占 1 个字节,专门用于处理纯英文 ASCII 字符。 - Unicode 字符(rune):使用单引号('')括起来,等同于
int32,固定占 4 个字节,用于处理包含中文在内的任意单个字符。
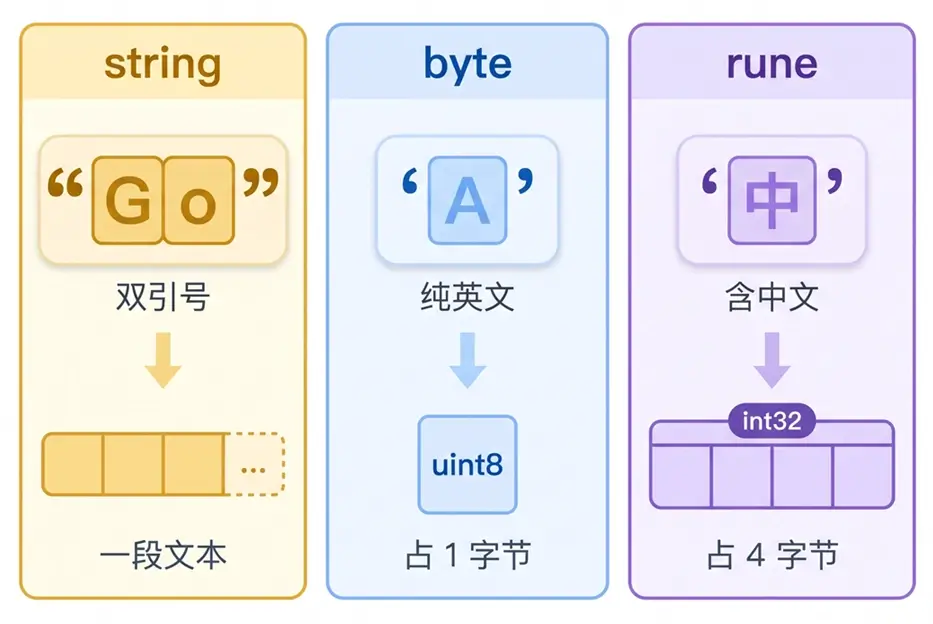
这里还要补充一个容易踩坑的细节:单个汉字 '中' 存进 rune 变量时固定占 4 个字节。但如果放进双引号字符串 "中" 中,Go 语言采用变长的 UTF-8 编码,1 个常用汉字只占 3 个字节。
比如 "Go语言" 看起来只有 4 个字符,在底层一共占 2 + 3 + 3 = 8 个字节。这一点在后面计算字符串长度时会经常用到。
下面我们通过一个示例,直观对比一下双引号 "A" 和单引号 'A' 的差异。
示例 3:单引号与双引号的区别
package main

import "fmt"

func main() {
    s := "A"    // 双引号表示 string 字符串
    c := 'A'    // 单引号表示 rune 字符

    fmt.Println(s, c)
    fmt.Printf("%T %T\n", s, c)
}运行结果如下。
A 65
string int32
分析:
虽然表面上看起来都是字母 A,但双引号 "A" 的类型是 string 字符串,打印出来就是文本 A;而单引号 'A' 的类型被自动推断为 int32(即 rune),直接打印出来的是整数编号 65。
正因为 byte 和 rune 本质上都是整数类型,所以它们可以直接参与加减法运算。请看下面例子。
示例 4:字符的加减运算
package main

import "fmt"

func main() {
    var ch byte = 'a'    // 'a' 的编码为 97
    upper := ch - 32     // 97 - 32 = 65
    fmt.Printf("%c\n", upper)
}运行结果如下。
A分析:
前面我们提过,同一个英文字母的小写编码比大写编码大 32。因此 ch - 32 表示将小写字母 'a' 的编号 97 减去 32 得到 65,正好对应大写字母 'A' 的 ASCII 编码。
最后使用 %c 打印 upper 时,输出的结果就是大写字母 A。小伙伴们也可以试着给大写字母 'A' 加上 32,看看能不能转回小写字母 'a'。
需要注意,上面代码之所以能直接写 ch - 32,是因为 32 是无类型数字常量。如果把一个 byte 变量和一个 rune 变量直接相加,由于它们底层分别是 uint8 和 int32,编译器会报类型不匹配错误。想要混合计算,必须先显式转换类型才行。
