



在 Go 语言中,字符串(string)从名字上就很好理解,指的就是一串字符。无论是英文单词、中文句子还是网址路径,只要是文本内容,我们都使用 string 类型来表示。
从底层来看,Go 字符串是由一串字节组成的 “不可变序列”,并且默认采用 UTF-8 编码来存储文字。
Go 字符串的定义
在 Go 语言中,定义单行字符串需要使用一对英文双引号(")把文字括起来(注意是英文)。这一点和 Python、JavaScript 不同,Go 语言不能使用单引号(')定义字符串,单引号只能用来表示单个字符,例如 'a'。
语法:
var 变量名 string = "字符串内容"
变量名 := "字符串内容"
说明:
定义字符串时,我们既可以使用 var 关键字显式指定 string 类型,也可以在函数内部使用 := 让编译器自动推导类型。双引号里面可以放英文字母、数字、符号或中文汉字。如果双引号内没有任何字符,也就是写成 "",则表示空字符串。
如果我们只声明了一个 string 变量而没有赋初值,它的默认零值就是空字符串 ""。此外,当一段文本需要跨越多行书写时,我们还可以使用反引号(`)来定义多行字符串,下一节会详细介绍。
示例 1:定义字符串
package main

import "fmt"

func main() {
    var s1 string = "Hello, Go!"
    s2 := "欢迎来到绿叶网!"
    var s3 string

    fmt.Println(s1)
    fmt.Println(s2)
    fmt.Println(s3 == "")    // 判断 s3 是否为空字符串
}运行结果如下。
Hello, Go!
欢迎来到绿叶网!
true
分析:
var s1 string = "Hello, Go!" 使用 var 显式指定了类型,而 s2 使用 := 简短声明(平时更推荐这种写法)。变量 s3 只声明未赋初值,默认零值就是 "",所以 s3 == "" 的结果为 true。
刚开始写 Go 代码时,小伙伴们千万不要把双引号和单引号混用。下面这两种写法中,使用单引号定义字符串是错误的。
// 正确方式
s := "lvye"

// 错误方式
s := 'lvye'
在 Go 语言中,单引号只能包裹单个字符(如 'l')。一旦把多个字符放进单引号里写成 'lvye',编译时就会报错。定义字符串时,哪怕里面只有一个字母(如 "l")甚至为空(如 ""),也必须使用英文双引号。
注意: 在 Go 语言中,字符串变量的默认零值是 "",永远不可能是 nil。因此我们不能像切片那样写 s = nil 或 s == nil,否则编译时会报错。
通过下标访问字节
在 Go 语言中,如果想要读取字符串中某一个位置的数据,我们可以像访问切片一样使用方括号下标 s[i],下标同样从 0 开始计算。以 s := "lvye" 为例,各个字符对应的下标位置如下表所示。
| 下标 | 字符 | ASCII 码 |
|---|---|---|
| 0 | 'l' | 108 |
| 1 | 'v' | 118 |
| 2 | 'y' | 121 |
| 3 | 'e' | 101 |
需要注意的是,s[i] 取出的是第 i 个位置的 byte 字节,而不是子字符串。下面我们来看一个例子。
示例 2:通过下标读取字节
package main

import "fmt"

func main() {
    s := "lvye"

    fmt.Println(s[0])           // 输出第 1 个字节的编码值
    fmt.Printf("%c\n", s[0])    // 按字符格式输出第 1 个字符
    fmt.Printf("%c\n", s[1])    // 按字符格式输出第 2 个字符
}运行结果如下。
108
l
v
分析:
s[0] 表示获取字符串 s 中下标为 0 的第 1 个字节,s[1] 表示获取下标为 1 的第 2 个字节。
可能有些小伙伴会问:“为什么执行 fmt.Println(s[0]) 输出的是数字 108,而不是字母 'l' 呢?”
这是因为前面学习 byte 与 rune 时我们讲过,byte 本质上是 uint8 整数类型。直接打印 s[0] 会输出字母 'l' 对应的 ASCII 码 108。如果希望显示字符本身,配合 fmt.Printf() 的 %c 格式符打印就可以了。
此外小伙伴们要注意,使用 s[i] 按下标取值只适合纯英文、数字等单字节字符。如果字符串里包含中文汉字,在 UTF-8 编码下每个常用汉字占 3 个字节,s[0] 只会取出汉字的第 1 个字节,单独打印出来就会变成乱码。
字符串的不可变与修改
对于切片来说,我们可以随时通过 nums[0] = 10 修改里面的元素。但在 Go 语言中,字符串是 “不可变的”。
所谓的不可变,就像已经印在纸上的文字一样。一旦字符串创建完成,它内部的字节内容就固定下来了,我们不能通过 s[0] = 'L' 修改里面的某一个字符。
示例 3:不能直接修改字符串
package main

import "fmt"

func main() {
    s := "lvye"
    s[0] = 'L'    // 编译报错:字符串不可修改
    fmt.Println(s)
}运行结果如下。
(报错)cannot assign to s[0] (neither addressable nor a map index expression)分析:
从运行结果可以看出,当我们尝试通过 s[0] = 'L' 把首字母改成大写时,程序无法通过编译,报出 cannot assign to s[0](无法给 s[0] 赋值)错误。
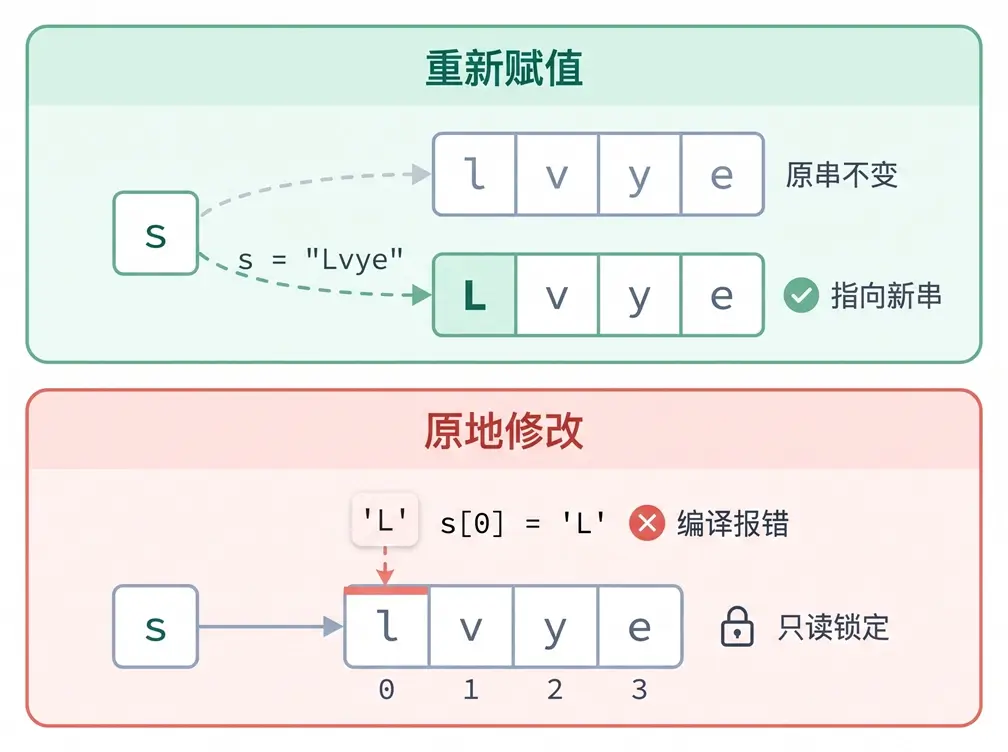
这里很多小伙伴容易把 “修改字符串内部字符” 和 “给字符串变量重新赋值” 搞混。我们可以对比一下下面这两种写法。
s := "lvye"

// 正确方式
s = "Lvye"

// 错误方式
s[0] = 'L'其中,s = "Lvye" 并不是去改动原来的 "lvye",而是在内存中新创建了一个字符串 "Lvye",再让变量 s 指向这个新字符串。而 s[0] = 'L' 则是想原地修改 "lvye" 内部的第 0 个字节,违反了不可变规则。两者的区别如下图所示。
那么,如果我们确实需要按位置修改字符串里的某几个字符,尤其是包含中文汉字的字符串,应该怎么做呢?
常用的做法是:先使用 []rune(s) 把字符串转换为 rune 切片,在切片里改好对应位置的字符后,再使用 string() 转回新的字符串。有关两者的底层转换细节,后面章节还会详细介绍。
示例 4:转为 []rune 切片修改字符
package main

import "fmt"

func main() {
    s := "go课程"
    chars := []rune(s)    // 转为 []rune 字符切片
    chars[0] = 'G'        // 修改第 1 个字符
    chars[2] = '教'       // 修改第 3 个字符
    s = string(chars)     // 重新转回 string 类型
    fmt.Println(s)
}运行结果如下。
Go教程分析:
在这个例子中,chars := []rune(s) 把字符串 "go课程" 按完整的字符拆开,放进切片 chars 中。此时不管是英文字母还是中文汉字,在切片里都只占 1 个位置,下标 0~3 依次对应 'g'、'o'、'课'、'程'。
由于切片元素可以自由修改,我们改好下标 0 和下标 2 的字符后,再调用 string(chars) 转回新字符串并赋给 s。需要注意,chars 里的每个元素都是单个 rune 字符,赋值时右侧必须使用单引号(如 'G'、'教'),不能写成双引号 "G"。
先转 []rune 切片再修改的方式,主要适合按固定位置改动单个字符。如果只是想把字符串里的某个旧词换成新词(比如把所有的 "hello" 换成 "hi"),调用标准库的 strings.ReplaceAll() 函数会省事不少。
字符串不可变的设计原因
直接修改 s[0] 看起来更省事,为什么 Go 语言要把字符串设计成只读不可变的呢?这主要有以下 2 个原因:
- 共享内存更安全:字符串的内容一旦确定就不会改变。当我们在多个变量或函数之间传递同一个字符串时,底层可以共用同一块内存数据,不用担心某处代码改动内容而影响其他地方。
- 可以安全地作为字典的键:在下一章学习 Map(字典)时我们会看到,字典要求 “键” 的内容必须固定不变,这样才能准确查找数据。正因为字符串不可变,它才能安全地充当字典的键。
