



当一个协程需要同时等待多个通道发来数据时,我们不能直接按顺序先写 <-ch1 再写 <-ch2。因为一旦 ch1 里暂时没有数据,程序就会一直卡在第 1 行干等,哪怕此时 ch2 早就收到数据了也没法及时处理。
为了解决多个通道同时等待的问题,Go 语言提供了 select 关键字。所谓的 “多路复用”,说白了就是使用一个 select 语句同时监听多条通道,哪条通道先准备好,就优先执行哪条分支。
Go select 基本用法
在 Go 语言中,select 语句的结构和 switch 语句非常相似,内部同样由多个 case 分支和一个可选的 default 分支组成。
不过两者有着明显的区别:switch 是按从上往下的顺序判断普通条件,而 select 后面不跟任何判断表达式,它的每一个 case 分支后面都必须是针对通道的接收或发送操作。
语法:
select {
case <-通道1:
    // 分支 1 代码
case 变量 := <-通道2:
    // 分支 2 代码
case 通道3 <- 值:
    // 分支 3 代码
default:
    // 默认分支代码
}
说明:
在 select 语句中,case 支持直接接收(<-通道1)、接收并赋给变量(变量 := <-通道2)以及发送数据(通道3 <- 值)三种通道操作。整个监听和选择流程如下图所示,执行时会遵循以下 2 条基本规则:
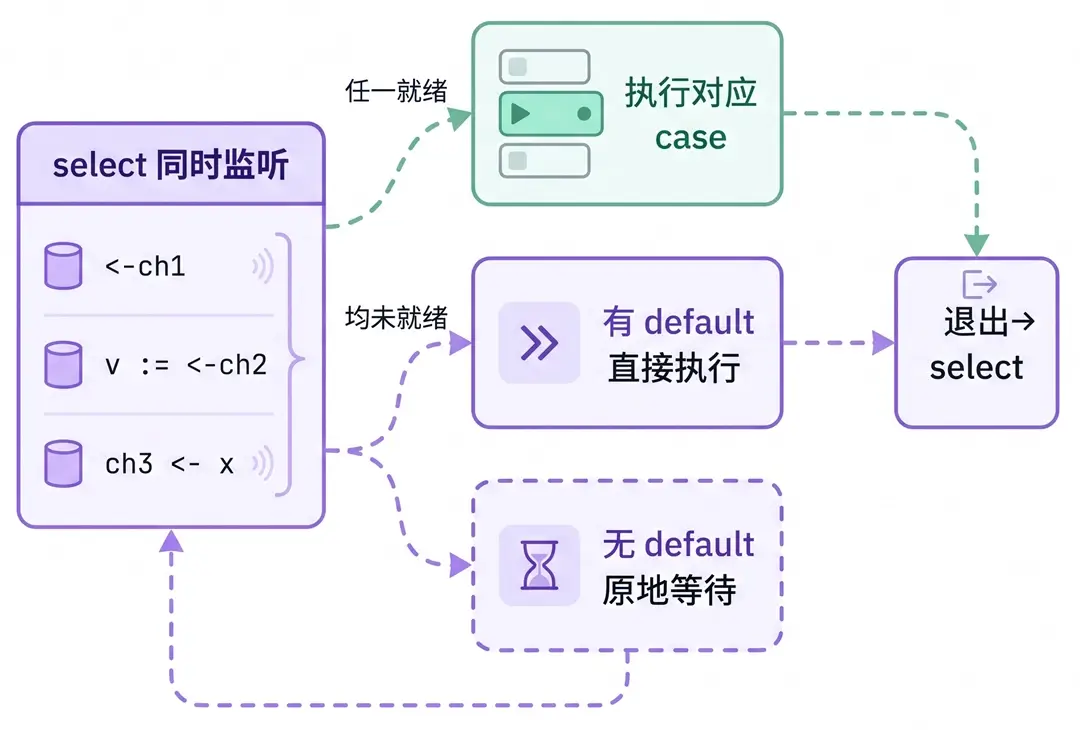
- 未写 default 分支:
select会停在原地等待,同时监听所有case里的通道操作。一旦其中某一个通道率先准备就绪,程序就会立即执行对应的case分支,执行完后自动退出当前select语句。 - 写了 default 分支:如果所有
case的通道在当前时刻都还没有准备好,select不会停下来等待,而是直接执行default分支。
示例 1:同时监听两个通道
package main

import (
    "fmt"
    "time"
)

func main() {
    ch1 := make(chan string)
    ch2 := make(chan string)

    // 子协程 1:200 毫秒后发送数据
    go func() {
        time.Sleep(200 * time.Millisecond)
        ch1 <- "来自通道 1 的消息"
    }()

    // 子协程 2:50 毫秒后发送数据
    go func() {
        time.Sleep(50 * time.Millisecond)
        ch2 <- "来自通道 2 的消息"
    }()

    select {
    case v1 := <-ch1:
        fmt.Printf("收到:%s\n", v1)
    case v2 := <-ch2:
        fmt.Printf("收到:%s\n", v2)
    }
}运行结果如下。
收到:来自通道 2 的消息分析:
在这个例子中,select 同时监听着 ch1 和 ch2 两个通道。由于子协程 1 需要休眠 200 毫秒,而子协程 2 只需要休眠 50 毫秒,因此子协程 2 会率先把数据发进 ch2。
当 ch2 收到数据的那一刻,case v2 := <-ch2: 分支立即被触发并打印出结果。这里小伙伴们要注意,单次 select 只要执行完其中一个分支就会直接退出。如果我们希望把两个通道的消息全部接收完,可以在 select 外面套上一层 for 循环,代码如下:
for i := 0; i < 2; i++ {
    select {
    case v1 := <-ch1:
        fmt.Printf("收到:%s\n", v1)
    case v2 := <-ch2:
        fmt.Printf("收到:%s\n", v2)
    }
}
注意: select 中的每一个 case 后面都必须是通道的读操作(如 <-ch)或写操作(如 ch <- v),不能写 case a > b: 这样的普通条件表达式,否则编译器会直接报错。
使用 time.After() 实现超时控制
当我们等待子协程通过通道返回结果时,如果子协程因为网络波动或接口故障迟迟没有发回数据,主协程就会在通道接收处无限期卡住。为了防止程序一直干等,我们可以使用 select 配合 time.After() 函数来实现超时控制。
与单纯暂停当前协程的 time.Sleep() 不同,time.After() 不会原地阻塞后续代码,而是立即返回一个只读通道,并在经过指定时长后自动向该通道发送时间信号。下面我们来看一个例子。
示例 2:实现通道超时控制
package main

import (
    "fmt"
    "time"
)

func main() {
    ch := make(chan string)

    // 模拟耗时 300 毫秒的慢任务
    go func() {
        time.Sleep(300 * time.Millisecond)
        ch <- "任务处理完成"
    }()

    select {
    case res := <-ch:
        fmt.Printf("收到结果:%s\n", res)
    case <-time.After(100 * time.Millisecond):
        fmt.Println("操作超时,不再继续等待")
    }
}运行结果如下。
操作超时,不再继续等待分析:
case <-time.After(100 * time.Millisecond): 表示设置了一个 100 毫秒的超时限制。如果在 100 毫秒之内 ch 收到了数据,程序就会走第 1 个分支正常打印结果。
上面的子协程需要 300 毫秒才能处理完任务。因此在满 100 毫秒时,time.After() 返回的通道会率先收到信号,程序就会走第 2 个分支打印 "操作超时,不再继续等待" 并退出 select。
对于单次超时等待,直接使用 time.After() 非常省事。但如果是在高频循环中反复做超时判断,每次调用 time.After() 都会创建一个新的计时对象,此时改用可复用的定时器会更节省内存。
使用 default 实现非阻塞读写
前面我们学过,直接从暂无数据的通道执行 <-ch 接收操作,或者向缓冲区已满的通道发送数据时,当前协程都会停在原地阻塞等待。如果我们希望通道就绪时就立刻收发数据,未就绪时也不要停下来等待,而是直接去执行其他逻辑,就可以在 select 中加上 default 分支。
示例 3:非阻塞读取通道
package main

import "fmt"

func main() {
    ch := make(chan int, 1)    // 创建通道,暂不放入数据

    select {
    case v := <-ch:
        fmt.Printf("收到数据:%d\n", v)
    default:
        fmt.Println("通道中暂无数据,执行 default 分支")
    }
}运行结果如下。
通道中暂无数据,执行 default 分支分析:
上面代码中,通道 ch 创建后并没有放入任何数据。如果我们不加 default 分支而直接读取 ch,程序就会触发 deadlock 死锁报错。加上 default 分支后,select 发现当前没有数据可读,便会立即执行 default 分支,实现 “非阻塞读取”。
非阻塞发送也是同样的道理。当我们在 case 中向缓冲区已满的通道发送数据时,只要带有 default 分支,当前写不进去就会直接走 default 分支,不会卡住当前协程。
这里要特别提醒小伙伴们一点:千万不要把带有 default 分支的 select 直接放进死循环 for {} 里空跑。一旦所有通道都没数据,程序就会每秒执行上百万次 default 分支,瞬间把 CPU 占用率跑满 100%。
如果确实需要在循环里持续监听通道,我们直接去掉 default 分支,让 select 自然阻塞等待就可以了。
在循环中跳出 select
当把 select 放在 for 循环中持续监听通道时,很多初学的小伙伴容易踩一个坑:在 case 分支内部直接写普通的 break 语句,结果发现外层循环根本停不下来。
这是因为普通的 break 只会跳出当前的 select 语句,而不会跳出外层的 for 循环。如果我们希望在某个分支中结束外层循环,除了使用 return 直接退出整个函数之外,还可以给 for 循环加上标签,配合 break 标签名 跳出外层循环。
示例 4:带标签跳出外层循环
package main

import "fmt"

func main() {
    ch := make(chan int)
    quit := make(chan bool)

    go func() {
        ch <- 10
        ch <- 20
        quit <- true      // 发送停止监听信号
    }()

loop:
    for {
        select {
        case v := <-ch:
            fmt.Printf("收到数据:%d\n", v)
        case <-quit:
            fmt.Println("收到退出信号,跳出循环")
            break loop    // 指定标签跳出外层 for 循环
        }
    }
    fmt.Println("后续代码正常执行")
}运行结果如下。
收到数据:10
收到数据:20
收到退出信号,跳出循环
后续代码正常执行
分析:
在这个例子中,我们在 for 循环正上方定义了一个名为 loop 的标签。当 quit 通道收到退出信号时,执行 break loop 就能一次性跳出外层的 for 循环,继续往下打印 "后续代码正常执行"。
如果这里只写普通的 break 而不带标签名,程序只会跳出当次的 select,下一轮又会回到 for 循环开头继续等待,最终引发死锁报错。要是跳出循环后不再需要执行当前函数的后续代码,我们也可以直接使用 return 退出函数,这一点小伙伴们不要搞混了。
常见问题
1. 如果在 select 执行的那一瞬间,恰好有两个 case 的通道同时准备就绪了,Go 会按从上往下的顺序先执行第 1 个吗?
不会。当 select 中有多个 case 分支在同一时刻都已经准备就绪时,Go 语言不会按代码从上往下的顺序固定选第 1 个,而是会在这些已就绪的分支中随机挑选一个来执行。
这样设计是为了保证各个通道之间的公平性,防止排在最前面的通道一直高频收发数据,导致排在后面的通道长期得不到执行机会。
