



当我们需要查看某个文件夹下有哪些文件和子文件夹,或者在多层目录中批量找出所有的 .txt 文本文件时,就需要对文件夹进行遍历。
在 Go 语言中,标准库提供了 2 种常用的目录遍历方式:一种是使用 os 包的 os.ReadDir() 函数,只读取当前第一层目录;另一种是使用 path/filepath 包的 filepath.WalkDir() 函数,自动深入每一个子文件夹进行递归遍历。
os.ReadDir() 遍历单层目录
如果我们只需要查看某个文件夹第一层包含哪些内容,不需要往子文件夹里面继续深入,直接使用 os.ReadDir() 函数就可以了。
语法:
entries, err := os.ReadDir(name)说明:
os.ReadDir() 接收目录路径字符串 name 作为参数,读取成功后会返回一个按文件名排好序的目录条目切片 entries(其中 entry 表示 “条目”)。我们可以使用 for range 循环遍历这个切片,并调用每个条目的常用方法:
- entry.Name():返回该文件或子文件夹本身的名称,不包含前面的父目录路径。
- entry.IsDir():判断该条目是否为子文件夹。如果是子文件夹则返回
true,如果是普通文件则返回false。
测试这一节的 4 个示例时,我们统一在当前工作目录下准备下面的 mydir 目录结构,里面包含 a.txt、b.go 以及子目录 sub/c.txt:
mydir/
    a.txt
    b.go
    sub/
        c.txt
示例 1:列出第一层目录内容
package main

import (
    "fmt"
    "os"
)

func main() {
    // 读取 mydir 的第一层目录内容
    entries, err := os.ReadDir("mydir")
    if err != nil {
        fmt.Println("读取目录失败:", err)
        return
    }

    for _, entry := range entries {
        if entry.IsDir() {
            fmt.Println("[目录]", entry.Name())
        } else {
            fmt.Println("[文件]", entry.Name())
        }
    }
}
运行结果如下。
[文件] a.txt
[文件] b.go
[目录] sub
分析:
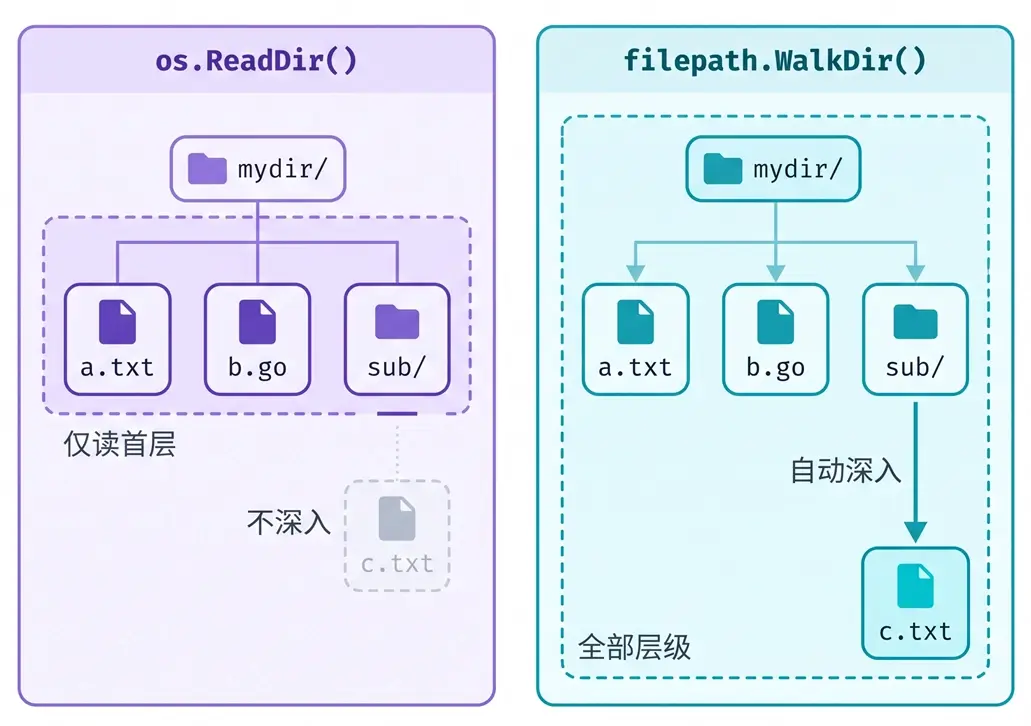
os.ReadDir("mydir") 会把 mydir 下的直接子项 a.txt、b.go 和子目录 sub 按字母顺序读取出来。但它不会进入 sub 子文件夹内部,因此子文件夹里的 c.txt 没有出现在结果中。
调用 entry.Name() 时,小伙伴们要特别留意:它返回的只是单纯的名称(如 "a.txt"),并不包含外层目录 "mydir"。
如果遍历时想接着调用 os.ReadFile() 读取文件,我们不能直接把 entry.Name() 传进去,而应该先通过 filepath.Join() 拼出完整路径,如下所示:
// 正确方式
fullPath := filepath.Join("mydir", entry.Name())
data, err := os.ReadFile(fullPath)

// 错误方式
data, err := os.ReadFile(entry.Name())
如果直接写成 os.ReadFile(entry.Name()),程序会跑去当前工作目录下寻找 a.txt,而不是去 mydir/a.txt 读取,运行时就会报错提示找不到文件。
filepath.WalkDir() 递归遍历目录
如果文件夹里面套着多层子文件夹,我们想把所有层级里的文件全部找出来,就可以使用 path/filepath 包中的 filepath.WalkDir() 函数。其中,WalkDir 是 “Walk Directory(走遍目录)” 的意思,它与 os.ReadDir() 的遍历范围对比如下图所示。
语法:
err := filepath.WalkDir(root, fn)说明:
filepath.WalkDir() 的第 1 个参数 root 是起始根目录路径,第 2 个参数 fn 是一个匿名函数(也常称为 “回调函数”),其固定声明格式为 func(path string, d fs.DirEntry, err error) error。
初学的小伙伴看到这么长的函数签名不用紧张,其实用法很简单。你只需要在这个匿名函数里写好 “每遇到一个文件或文件夹时要做什么”,filepath.WalkDir() 每往前走一步就会自动调用一次它,并传入以下 3 个参数:
- path:当前遍历到的完整路径,已经自动拼接好了父目录,比如
"mydir/sub/c.txt"。 - d:当前条目的信息对象,类型为
fs.DirEntry(需要导入io/fs包)。我们可以调用d.Name()获取名称、调用d.IsDir()判断是否为目录。 - err:访问当前路径时遇到的错误。如果一切正常,匿名函数最后返回
nil即可继续往下遍历。
示例 2:递归遍历所有子目录
package main

import (
    "fmt"
    "io/fs"
    "path/filepath"
)

func main() {
    // 递归遍历 mydir 及其所有子目录
    err := filepath.WalkDir("mydir", func(path string, d fs.DirEntry, err error) error {
        if err != nil {
            return err
        }
        fmt.Println(path)
        return nil
    })
    if err != nil {
        fmt.Println("遍历出错:", err)
    }
}
运行结果如下。
mydir
mydir/a.txt
mydir/b.go
mydir/sub
mydir/sub/c.txt
分析:
从运行结果可以看出,filepath.WalkDir() 第 1 步会先访问起始根目录 mydir 本身,因此第 1 行输出了 mydir。接着它会依次列出第一层的文件,遇到子文件夹 mydir/sub 时还会自动深入进去,找出里面的 mydir/sub/c.txt。
与 os.ReadDir() 不同,这里的回调参数 path 已经自动带上了完整的目录层级,我们可以直接把它传给 os.ReadFile() 读取文件内容。
另外,如果遍历途中遇到没有访问权限的子目录,回调函数里写 return err 会立刻中止整个遍历;如果想跳过报错继续扫描其他目录,改为打印提示后 return nil 就可以了。
提示: filepath.WalkDir() 是 Go 1.16 引入的新函数。早期代码中常见的旧函数 filepath.Walk() 每遍历到一个文件都会额外查询一次完整的磁盘属性,文件较多时速度偏慢,因此现在统一推荐使用效率更高的 filepath.WalkDir()。
遍历并筛选指定后缀文件
在实际开发中,我们递归遍历文件夹通常是为了找出某一类特定格式的文件,比如找出目录下所有的 .txt 文本文件或 .log 日志文件。这时只需要在匿名函数中排除掉文件夹,再使用 filepath.Ext(path) 比对扩展名即可。下面我们来看一个例子。
示例 3:筛选所有的 .txt 文件
package main

import (
    "fmt"
    "io/fs"
    "path/filepath"
)

func main() {
    err := filepath.WalkDir("mydir", func(path string, d fs.DirEntry, err error) error {
        if err != nil {
            return err
        }

        // 排除文件夹,只保留扩展名为 .txt 的文件
        if !d.IsDir() && filepath.Ext(path) == ".txt" {
            fmt.Println("找到文本文件:" + path)
        }
        return nil
    })
    if err != nil {
        fmt.Println("遍历出错:", err)
    }
}
运行结果如下。
找到文本文件:mydir/a.txt
找到文本文件:mydir/sub/c.txt
分析:
在这个例子中,我们在匿名函数里组合了两个筛选条件。首先通过 !d.IsDir() 排除掉所有文件夹,防止某个文件夹的名字刚好以 .txt 结尾。接着再判断 filepath.Ext(path) 是否等于 ".txt",最终找出了两层目录中的 mydir/a.txt 和 mydir/sub/c.txt。
需要注意,filepath.Ext() 返回的扩展名是区分大小写的。如果目录里还混有大写后缀的文件(比如 "README.TXT"),我们可以用 strings.ToLower() 先统一转成小写,也就是写成 strings.ToLower(filepath.Ext(path)) == ".txt"。
filepath.SkipDir 跳过指定子目录
扫描真实项目目录时,里面经常包含像 .git、vendor 或 node_modules 这样文件极多但又不需要处理的文件夹。如果每次都钻进去逐个扫描,不仅浪费时间,还容易混入无关文件。
遇到需要绕开的子文件夹,我们可以在匿名函数中判断目录名并返回特殊标记 filepath.SkipDir(其中 SkipDir 表示 “跳过目录”)。一旦收到这个返回值,filepath.WalkDir() 就会直接跳过整个子文件夹,继续扫描后面的其他内容。
示例 4:跳过指定的子目录
package main

import (
    "fmt"
    "io/fs"
    "path/filepath"
)

func main() {
    err := filepath.WalkDir("mydir", func(path string, d fs.DirEntry, err error) error {
        if err != nil {
            return err
        }

        // 遇到名为 sub 的子目录时直接跳过
        if d.IsDir() && d.Name() == "sub" {
            return filepath.SkipDir
        }

        fmt.Println(path)
        return nil
    })
    if err != nil {
        fmt.Println("遍历出错:", err)
    }
}
运行结果如下。
mydir
mydir/a.txt
mydir/b.go
分析:
对比示例 2 的运行结果可以清楚看到,当遍历走到子文件夹 sub 时,满足了是目录且名称为 "sub" 的条件,匿名函数立刻返回了 filepath.SkipDir。
这里有一个很容易踩的坑:判断条件里的 d.IsDir() 千万不要省略。为什么呢?
因为如果对一个 “普通文件” 返回了 filepath.SkipDir,filepath.WalkDir() 会直接跳过该文件所在父目录里剩下的所有内容。只有先确认 d.IsDir() 为 true,它才会只跳过当前这个子目录本身。
另外,filepath.SkipDir 并不是真正的运行报错,它只是发给 filepath.WalkDir() 的一个 “绕行信号”。因此外层的返回值 err 依然为 nil,程序在跳过 mydir/sub 及其内部的 c.txt 后会正常结束,不会触发外层的错误提示。
