



在 Go 语言中,读取本地文件主要有 2 种常用方式:文件较小时,我们可以使用 os.ReadFile() 一次性把整个文件读进内存;文件体积很大时,则使用 os.Open() 配合 bufio.NewScanner() 按行读取。遇到特殊二进制文件时,还可以按固定字节数分块读取。
其中,os 是 “operating system(操作系统)” 的缩写,而 bufio 是 “buffered I/O(带缓冲的输入输出)” 的缩写。由于读写本地磁盘依赖电脑的文件系统,这一章的文件操作示例需要小伙伴们在本地开发环境中运行测试。
一次性读取:os.ReadFile()(推荐)
如果文件体积不大,比如日常的配置文件或短文本文件,最直接的做法就是使用 os.ReadFile() 函数一次性读取文件的全部内容。
语法:
data, err := os.ReadFile(name)说明:
os.ReadFile() 接收文件路径字符串 name 作为参数,并返回两个值。第 1 个返回值 data 是包含文件全部内容的字节切片 []byte,第 2 个返回值 err 是错误信息。如果读取成功,err 的值为 nil。
在运行下面的代码之前,我们先在当前项目的根目录下新建一个名为 hello.txt 的文本文件,写入以下 3 行内容并保存,后面的按行读取示例也会共用这个文件:
Go 基础语法
Go 并发编程
Go 文件操作
示例 1:读取全部内容
package main

import (
    "fmt"
    "os"
)

func main() {
    // 一次性读取整个文件
    data, err := os.ReadFile("hello.txt")
    if err != nil {
        fmt.Println("读取失败:", err)
        return
    }

    // 转为字符串并打印
    fmt.Println(string(data))
}
运行结果如下。
Go 基础语法
Go 并发编程
Go 文件操作
分析:
os.ReadFile("hello.txt") 表示把当前工作目录下 hello.txt 中的所有数据一次性读取出来,并保存到变量 data 中。如果运行时提示找不到文件,小伙伴们可以调用 filepath.Abs() 传入 ".",打印确认一下终端当前所在的工作目录。
这里需要注意,data 的类型是字节切片 []byte,直接执行 fmt.Println(data) 会输出一串字节数字编码。我们在外层套上 string(data) 就能把它转换成可读的字符串,关于两者转换的更多细节会在后面的 “string 与 byte 切片互转” 一节中展开介绍。
提示: os.ReadFile() 在内部已经自动完成了 “打开文件 → 读取全部内容 → 关闭文件” 的完整流程,因此不需要我们再手动调用 Close() 关闭文件。日常读取普通小文件时,优先使用这一种方式就可以了。
按行读取:bufio.NewScanner()
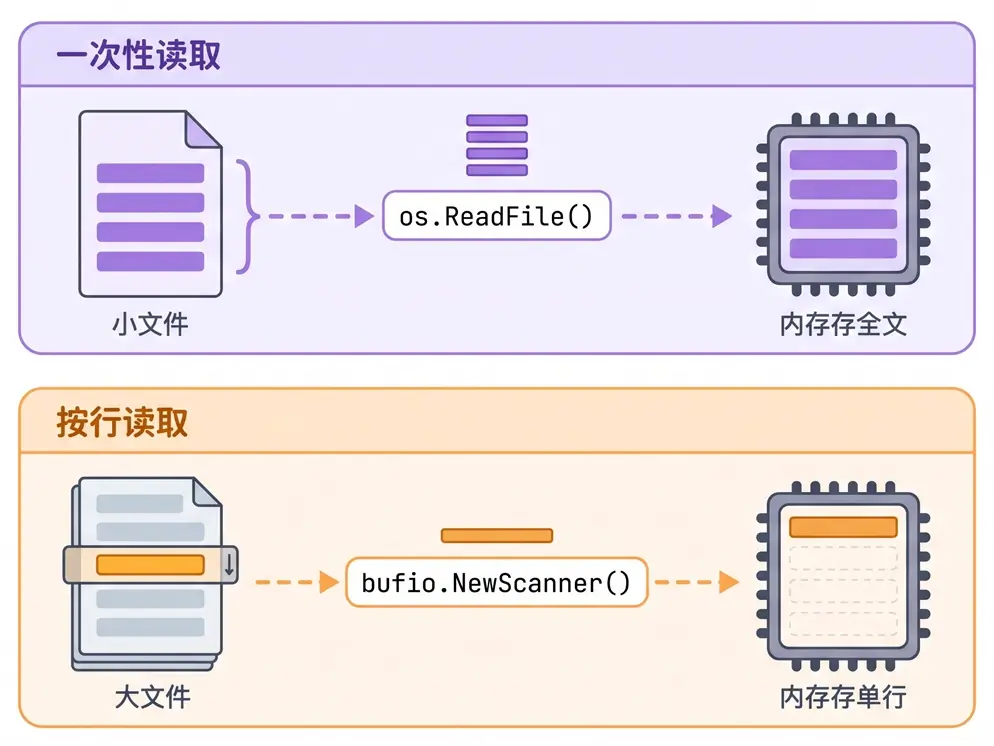
os.ReadFile() 就像一口气把整瓶水喝完,虽然简单干脆,但遇到几百 MB 甚至几个 GB 的大型日志文件时,一次性全读进内存就容易把内存撑爆。这时我们可以使用 os.Open() 打开文件,再配合 bufio.NewScanner() 一行一行地读取内容,两者的读取方式对比如下图所示。
语法:
file, err := os.Open(name)
scanner := bufio.NewScanner(file)
说明:
os.Open() 以只读方式打开文件,并返回文件对象 file 和错误值 err。使用 bufio.NewScanner() 按行读取文件通常分为以下 4 步:
- 打开文件:我们调用
os.Open()打开目标文件,并在确认err == nil后,配合 defer 语句写上defer file.Close(),确保函数退出时自动关闭文件。 - 创建扫描器:我们把打开的文件对象传入
bufio.NewScanner(file),创建一个按行读取的扫描器scanner。 - 循环逐行读取:通过
for scanner.Scan()循环往后推进。每次调用scanner.Scan()都会读取下一行并返回true,读完整个文件后返回false并结束循环。 - 获取文本并检查错误:在循环内部调用
scanner.Text()即可拿到去掉了行尾换行符的当前行字符串。循环结束后,我们再调用scanner.Err()检查读取中途是否出错。
示例 2:按行读取文件
package main

import (
    "bufio"
    "fmt"
    "os"
)

func main() {
    file, err := os.Open("hello.txt")
    if err != nil {
        fmt.Println("打开文件失败:", err)
        return
    }
    defer file.Close()    // 函数退出时关闭文件

    // 创建扫描器并逐行读取
    scanner := bufio.NewScanner(file)
    lineNum := 1
    for scanner.Scan() {
        fmt.Printf("第 %d 行:%s\n", lineNum, scanner.Text())
        lineNum++
    }

    // 检查扫描过程是否出错
    if err := scanner.Err(); err != nil {
        fmt.Println("读取出错:", err)
    }
}
运行结果如下。
第 1 行:Go 基础语法
第 2 行:Go 并发编程
第 3 行:Go 文件操作
分析:
在这个例子中,我们直接复用了前面准备好的 hello.txt。每次循环执行 scanner.Scan() 时,程序只会把文件中的一行文本读入内存,通过 scanner.Text() 就能拿到当前行的内容。由于内存中每次只保留一行数据,就算文件再大也不会占用过多内存。
使用 os.Open() 打开文件时,有一点需要特别注意:defer file.Close() 必须放在 if err != nil 错误判断的后面,不能提前写在前面。正误写法对比如下:
// 正确方式
file, err := os.Open("hello.txt")
if err != nil {
    return
}
defer file.Close()

// 错误方式
file, err := os.Open("hello.txt")
defer file.Close()
if err != nil {
    return
}
为什么不能提前写呢?如果把 defer file.Close() 写在了错误检查前面,一旦文件不存在导致打开失败,此时的 file 就是空指针 nil。当函数执行 return 退出并触发 defer 时,程序对 nil 调用方法就会直接崩溃。
提示: bufio.NewScanner() 默认的单行缓冲区上限是 64KB,日常读取普通文本足够用了。如果遇到单行超过 64KB 的超长文本行,我们可以先调用 scanner.Buffer() 调大缓冲区,或者改用下面的分块读取方式。
按固定字节分块读取(了解)
除了整篇读取和按行读取之外,有时我们还需要每次固定读取指定字节数的数据,比如处理图片、音视频等二进制文件,或者没有换行符的超长文本。这时我们可以先使用 make() 创建一个固定长度的 []byte 切片作为缓冲区,再在循环中调用 file.Read(buf) 方法。
语法:
n, err := file.Read(buf)说明:
file.Read(buf) 会尝试往字节切片 buf 中装满数据,并返回本次实际读到的字节数 n 和错误值 err。当读到文件末尾没有更多数据时,它会返回 io 包中的 io.EOF,其中 EOF 是 “End Of File(文件末尾)” 的缩写。
为了直观观察每次读取的字节变化,我们先准备一个测试文件 letters.txt,在里面写入 8 个英文字母 ABCDEFGH 并保存(注意不要在末尾多敲回车,否则文件会多出一个换行字节)。
示例 3:按固定字节分块读取
package main

import (
    "fmt"
    "io"
    "os"
)

func main() {
    file, err := os.Open("letters.txt")
    if err != nil {
        fmt.Println("打开失败:", err)
        return
    }
    defer file.Close()

    // 创建长度为 3 的字节切片作为缓冲区
    buf := make([]byte, 3)
    for {
        n, err := file.Read(buf)
        if n > 0 {
            fmt.Println("本次读到:" + string(buf[:n]))
        }
        if err == io.EOF {
            break    // 读到文件末尾,退出循环
        }
        if err != nil {
            fmt.Println("读取出错:", err)
            break
        }
    }
}
运行结果如下。
本次读到:ABC
本次读到:DEF
本次读到:GH
分析:
上面代码先用 make([]byte, 3) 创建了一个长度为 3 的字节切片,因此 file.Read(buf) 每次最多往 buf 里装入 3 个字节,并返回实际读到的字节数 n。
循环中我们先判断 if n > 0 处理刚读到的数据,再判断 err == io.EOF 跳出循环。因为按 Go 语言标准库的约定,最后一次读取既可能只返回 io.EOF,也可能把最后剩下的几个字节和 io.EOF 一起返回,先处理再退出就不会漏掉末尾数据。
这里小伙伴们还要特别留意,打印结果时我们通过切片截取写成了 string(buf[:n]),而不能直接写成 string(buf)。我们可以看看 3 轮读取中缓冲区 buf 的变化过程:
- 第 1 次读取:读入 3 个字节,
n的值为 3,buf中的内容为"ABC"。 - 第 2 次读取:读入 3 个字节,
n的值为 3,覆盖旧数据后buf中的内容变为"DEF"。 - 第 3 次读取:文件末尾只剩两个字节,
n的值为 2。新读入的"GH"只覆盖了前两个位置,第 3 个位置还残留着上一轮的字符'F'。
如果不加 [:n] 直接打印 string(buf),最后一次就会多打印出一个残留的字符 'F'。因此每次分块读取后,我们都应该只取出前 n 个字节。
此外,UTF-8 编码下一个汉字通常占用 3 个字节。如果用固定长度的字节切片去读中文文本,很容易在缓冲区边界把同一个汉字截成两半,直接转成 string 打印就会乱码。因此日常读取中文文件时,你优先使用 os.ReadFile() 或 bufio.NewScanner() 就可以了。
已废弃的 io/ioutil 包
小伙伴们在翻看一些早期的 Go 语言资料或开源项目时,可能会看到代码里导入了 io/ioutil 包,并使用 ioutil.ReadFile() 来读取文件。
在 Go 1.16 版本之前,读写文件确实常借助 io/ioutil 包。从 Go 1.16 开始,官方为了简化标准库结构将该包标记为废弃,并把里面的常用函数直接迁移到了 os 包和 io 包中。
平时阅读旧代码遇到 ioutil.ReadFile() 时,我们知道它等价于 os.ReadFile() 即可;自己编写新代码时,统一使用 os.ReadFile() 就可以了。
