



在 Go 语言中,把字符串里的字符逐个取出来,就叫做 “遍历字符串”。常用的实现方式有 2 种:一种是使用 for range 按完整的字符遍历,另一种是使用普通的 for 循环按底层的字节遍历。
for range 按字符遍历(推荐)
在 Go 语言中,最常用也最安全的遍历方式是使用 for range 循环。它会自动识别 UTF-8 编码,每次循环都取出一个完整的 rune 字符,不管是英文字母还是中文汉字都不会出现乱码。
语法:
for index, char := range str {
    // 循环体
}
说明:
在每次循环中,for range 会返回以下 2 个值:
- index:当前字符在字符串中起始位置的字节下标,类型为
int。 - char:当前位置取出的完整字符,类型为
rune。打印该字符时需要配合%c格式符,或者使用string(char)转成字符串。
如果在循环体中不需要用到位置下标 index,我们必须使用下划线 _ 将其忽略,写成 for _, char := range str,否则编译器会报变量未使用的错误。
示例 1:遍历含中文的字符串
package main

import "fmt"

func main() {
    s := "Go软件"
    for i, r := range s {
        fmt.Printf("下标:%d,字符:%c\n", i, r)
    }
}运行结果如下。
下标:0,字符:G
下标:1,字符:o
下标:2,字符:软
下标:5,字符:件
分析:
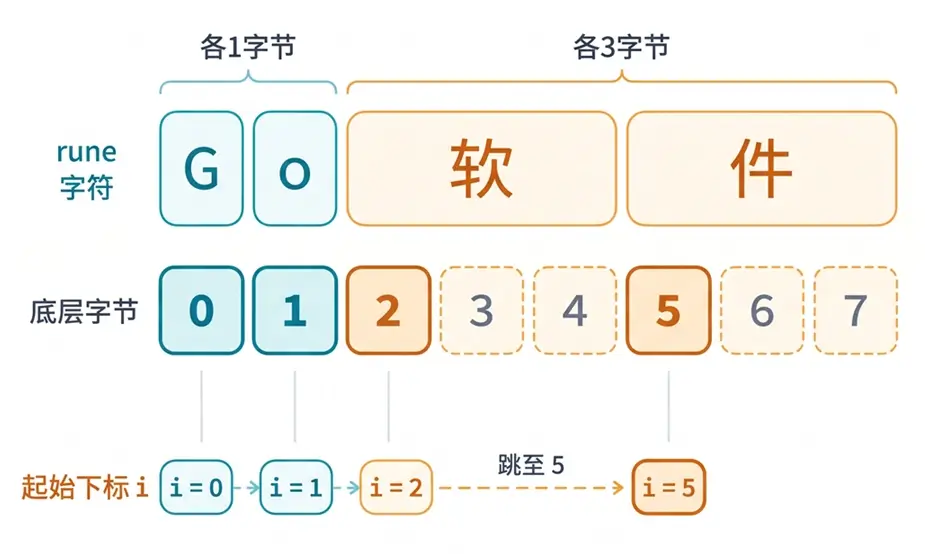
从运行结果可以看出,"Go软件" 中的两个英文字母和两个中文汉字都被完整打印了出来。不过仔细观察输出的下标 i(0、1、2、5),为什么最后一个 '件' 字的下标不是 3,而是从 2 跳到了 5 呢?
这是因为 for range 返回的 i 是每个字符的 “起始字节下标”。其中 'G' 和 'o' 各占 1 个字节(下标 0 和 1),汉字 '软' 占用了 2、3、4 共 3 个字节,因此后面的 '件' 字就从下标 5 开始了,如下图所示。
平时我们如果只需要依次读取字符本身,并不关心字节下标,可以直接使用 _ 忽略第 1 个返回值:
for _, r := range s {
    fmt.Printf("%c\n", r)
}
注意: 在 for i, r := range s 中,r 是 rune 类型(本质是整数)。执行 fmt.Println(r) 会打印出编码数字(如 'G' 输出 71),要显示字符本身,小伙伴们记得使用 fmt.Printf("%c\n", r) 或 string(r)。
普通 for 循环按字节遍历
除了 for range 之外,我们也可以使用普通的 for 循环,通过下标 s[i] 逐个字节遍历字符串。这种方式只适合纯英文、数字或半角符号组成的单字节字符串。
语法:
for i := 0; i < len(str); i++ {
    // 使用 str[i] 访问第 i 个字节
}
说明:
因为 len() 获取的是字符串的字节总数,而且 str[i] 每次只取出 1 个字节(byte 类型),所以当字符串只包含英文字母时可以正常遍历。一旦字符串里包含中文汉字,普通 for 循环就会把一个汉字拆成 3 个单独的字节,打印出来就会出现乱码。
示例 2:遍历纯英文字符串
package main

import "fmt"

func main() {
    s := "lvye"
    for i := 0; i < len(s); i++ {
        fmt.Printf("%c ", s[i])
    }
    fmt.Println()
}运行结果如下。
l v y e分析:
s 是纯英文字符串 "lvye",每个字母固定占 1 个字节,因此配合 s[i] 可以正常逐个输出 4 个字母。
如果把字符串换成前面包含中文汉字的 "Go软件",依然按字节遍历会发生什么呢?下面我们再来看一个例子。
示例 3:按字节遍历中文出现乱码
package main

import "fmt"

func main() {
    s := "Go软件"
    for i := 0; i < len(s); i++ {
        fmt.Printf("%c ", s[i])
    }
    fmt.Println()
}运行结果如下。
G o è ½ ¯ ä » ¶分析:
从运行结果可以看出,前面的英文字母 G 和 o 输出正常,但后面的中文部分却变成了 6 个奇怪的符号。
这是因为 "软件" 两个汉字共占 6 个字节,普通 for 循环把它们拆成了 6 个单独的字节数值(都在 128~255 之间)。当 %c 把每个单字节数值各自当成独立编码去查字符表时,刚好落在了带音标的拉丁符号区,于是就印出了这一串乱码。
转为 []rune 切片获取连续序号
在前面的示例 1 中我们看到,直接使用 for i, r := range s 遍历含中文的字符串时,拿到的字节下标 i 是跳跃的(0、1、2、5)。
如果我们需要拿到 0、1、2、3 这样连续递增的字符下标,可以先通过 []rune(s) 把字符串转换为字符切片,然后再遍历这个切片。下面我们来看一个例子。
示例 4:转为 []rune 获取连续下标
package main

import "fmt"

func main() {
    s := "Go软件"
    runes := []rune(s)    // 转为 []rune 字符切片
    for i, r := range runes {
        fmt.Printf("下标:%d,字符:%c\n", i, r)
    }
}运行结果如下。
下标:0,字符:G
下标:1,字符:o
下标:2,字符:软
下标:3,字符:件
分析:
runes := []rune(s) 表示把字符串拆成包含 4 个元素的字符切片。此时我们遍历切片 runes,拿到的下标 i 就是连续的 0、1、2、3,不会再出现示例 1 那种跳号的情况。
平时如果小伙伴们只是想依次读取字符串里的每个字符,直接使用 for _, r := range s 就足够了,不需要额外转换切片。只有明确需要连续的字符下标时,我们才需要先转为 []rune 切片。
