



如果我们定义一个变量 count := 0,然后启动 10 个协程,让每个协程都循环对 count 执行 10000 次加 1 操作,最终结果是不是一定是 100000 呢?直接运行程序后,结果通常会比 100000 少一大截,每次算出来的数字还都不太一样。
为什么会少算呢?这是因为多个协程在同一时刻争抢修改同一个共享变量,发生了 “数据竞争(Data Race)”。为了保证共享变量在同一时刻只被一个协程修改,我们就需要使用 sync 包提供的 “互斥锁(sync.Mutex)” 和 “读写锁(sync.RWMutex)”。
为什么会发生数据竞争?
在学习如何加锁之前,我们先通过一段完整的代码,直观看看多个协程在不加锁时同时修改同一个变量会发生什么现象。
示例 1:不加锁引发数据竞争
package main

import (
    "fmt"
    "sync"
)

func main() {
    count := 0
    var wg sync.WaitGroup

    // 启动 10 个协程累加 count
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            for j := 0; j < 10000; j++ {
                count++    // 多个协程同时修改
            }
        }()
    }

    wg.Wait()
    fmt.Printf("最终 count 的值:%d\n", count)
}运行结果如下。
最终 count 的值:68425分析:
count++ 表面上看只是一行简单的代码,但在计算机底层执行时,它实际上分成了以下 3 个步骤:
- 从内存中读取
count当前的值(假设当前为 50)。 - 将读取到的值加 1,计算出结果 51。
- 把算出的新值 51 写回内存的
count中。
当 10 个协程并发运行时,假设协程 A 和协程 B 在同一时刻都执行了第 1 步,它们读到的旧值都是 50。接着双方各自加 1 算出 51,又先后把 51 写回内存。
明明两个协程各加了一次,结果 count 只从 50 变成了 51,其中一次加法被直接覆盖丢失了。由于每次运行时协程争抢的时机不同,最终打印出来的数字每次都可能不一样。如果在电脑上运行极快、某次凑巧算出了 100000,小伙伴们多运行几次就能看到少算的现象。
提示: 在本地开发时,我们可以在运行命令中加上 -race 参数,也就是执行 go run -race main.go。这样可以开启 Go 自带的数据竞争检测器,哪怕某次运行结果凑巧正确,它也能自动帮我们找出潜在的并发读写冲突。
互斥锁(sync.Mutex)
在 Go 语言中,解决并发覆盖最直接的办法就是给修改共享变量的代码加上一把互斥锁 sync.Mutex。其中,Mutex 是英文 “mutual exclusion(互斥)” 的缩写。
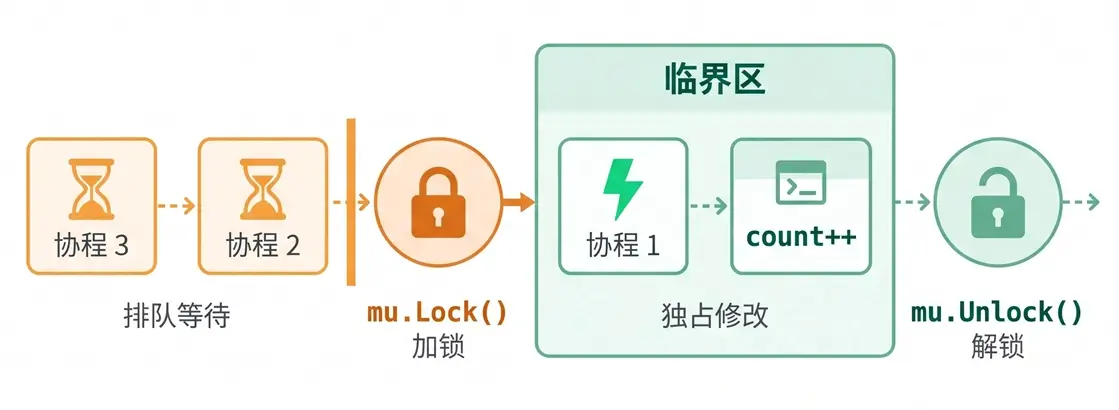
互斥锁就像商场里的单人试衣间:只要有一个协程进去把门锁上,其他协程就必须在门外排队等待。直到里面的协程处理完数据把门打开,下一个协程才能进去操作,如下图所示。
语法:
var mu sync.Mutex

mu.Lock()
// 操作共享变量的代码
mu.Unlock()
说明:
与 sync.WaitGroup 一样,sync.Mutex 也是值类型的结构体。我们声明 var mu sync.Mutex 后即可直接使用,不需要调用 make() 初始化。
位于 mu.Lock() 和 mu.Unlock() 之间的代码区域通常称为 “临界区”,同一时刻最多只允许一个协程进入该区域执行。
示例 2:使用互斥锁保护变量
package main

import (
    "fmt"
    "sync"
)

func main() {
    count := 0
    var wg sync.WaitGroup
    var mu sync.Mutex          // 声明互斥锁

    for i := 0; i < 10; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            for j := 0; j < 10000; j++ {
                mu.Lock()      // 修改前加锁
                count++
                mu.Unlock()    // 修改后解锁
            }
        }()
    }

    wg.Wait()
    fmt.Printf("最终 count 的值:%d\n", count)
}运行结果如下。
最终 count 的值:100000分析:
在这个例子中,我们在 count++ 上方调用了 mu.Lock() 加锁,下方调用了 mu.Unlock() 解锁。当某个协程拿到锁执行 count++ 时,其他协程都会停在 mu.Lock() 处排队等待,不会插队读取旧值,因此最终结果稳定为 100000。
在实际项目中,我们一般不会把锁和共享变量零散地定义为全局变量,而是习惯把它们一起封装进同一个结构体中,并在方法开头通过 defer 语句配合 defer a.mu.Unlock() 自动解锁。这样就算方法内部有多个分支提前返回,也能确保退出时把锁解开。请看下面例子。
示例 3:结构体封装互斥锁
package main

import (
    "fmt"
    "sync"
)

type Account struct {
    mu      sync.Mutex
    balance int
}

func (a *Account) Withdraw(amount int, wg *sync.WaitGroup) {
    defer wg.Done()
    a.mu.Lock()            // 进入方法加锁
    defer a.mu.Unlock()    // 退出方法自动解锁

    if a.balance >= amount {
        a.balance -= amount
        fmt.Printf("取款 %d 元,余额:%d 元\n", amount, a.balance)
    } else {
        fmt.Printf("余额不足,取款 %d 元失败\n", amount)
    }
}

func main() {
    acc := Account{balance: 1000}
    var wg sync.WaitGroup

    wg.Add(2)
    go acc.Withdraw(600, &wg)
    go acc.Withdraw(600, &wg)

    wg.Wait()
}运行结果如下。
取款 600 元,余额:400 元
余额不足,取款 600 元失败
分析:
在这个例子中,我们把互斥锁 mu 和账户余额 balance 一起放进了 Account 结构体里,并为 Withdraw() 方法使用了指针接收者 (a *Account)。这样哪个字段归哪把锁管一目了然,也非常方便复用。
当两个协程同时尝试从 1000 元余额中取款 600 元时,两次取款会按先后顺序依次执行。第 1 个协程取走 600 元后,账户余额变为 400 元;第 2 个协程再进入临界区检查 a.balance >= amount 时就会提示余额不足,避免了双方都取款成功导致余额变成负数的错误。
在使用 sync.Mutex 时,小伙伴们还要特别注意遵守以下 3 条规则。
- 加锁与解锁必须成对出现:调用
Lock()加锁后,一定要记得调用Unlock()解锁。此外 Go 的互斥锁不支持 “重入”,如果函数 A 加锁后还没解锁,内部又调用了同样会加这把锁的函数 B,程序就会直接卡死并触发deadlock死锁报错。 - 只对必要代码加锁:我们应该尽量缩小加锁包裹的代码范围,只把真正读写共享变量的那几行代码放进
Lock()和Unlock()之间。与共享变量无关的耗时操作应该放在锁外面,减少其他协程排队等待的时间。 - 不要按值复制传递互斥锁:
sync.Mutex是值类型的结构体。如果需要把锁(或包含锁的结构体)作为参数传给其他函数,形参必须写成结构体指针,比如*sync.Mutex或*Account。一旦按值传递,函数内部锁住的只是一个全新的副本,根本保护不了外面的共享变量。
读写锁(sync.RWMutex)
互斥锁 sync.Mutex 虽然简单可靠,但它不管协程是修改数据还是仅仅查看数据,同一时刻都只允许一个协程进入。
在实际项目中,很多业务属于 “读多写少” 的场景,比如高频读取系统的全局配置信息。如果多个协程只是同时读取变量的值、谁都不去修改它,其实根本不会发生数据冲突。这时如果还使用 sync.Mutex 让所有只读协程排队逐个读取,就会降低读取效率。
针对这种 “读多写少” 的场景,Go 语言提供了读写锁 sync.RWMutex。你可以把它想象成教室里的黑板:当老师在黑板上擦写新内容时,其他人既不能上去写也不能看。但当老师写完退开后,全班同学可以同时抬头看黑板,不需要排队逐个看。
语法:
var rw sync.RWMutex

// 读操作:加读锁与解读锁
rw.RLock()
// 读取共享变量
rw.RUnlock()

// 写操作:加写锁与解写锁
rw.Lock()
// 修改共享变量
rw.Unlock()
说明:
sync.RWMutex 的并发规则可以概括为 “读读共享、读写互斥、写写互斥”,具体包含以下两套方法:
- RLock() 与 RUnlock():读锁,其中的
R代表 “Read(读取)”。当协程只读取而不修改共享变量时,我们调用这套方法。多个协程可以同时持有读锁,互不阻塞;但只要还有协程拿着读锁,写锁就必须等待。 - Lock() 与 Unlock():写锁。当协程需要修改共享变量时,我们调用这套方法。写锁是完全独占的,一旦某个协程拿到了写锁,其他想要加读锁或写锁的协程都必须排队等待。
示例 4:使用读写锁并发读取
package main

import (
    "fmt"
    "sync"
    "time"
)

var (
    config = 100
    rw     sync.RWMutex
)

// 读取配置:使用读锁
func readConfig(id int, wg *sync.WaitGroup) {
    defer wg.Done()
    rw.RLock()
    defer rw.RUnlock()
    fmt.Printf("读者 %d:开始读取,配置为 %d\n", id, config)
    time.Sleep(50 * time.Millisecond)
    fmt.Printf("读者 %d:读取完毕\n", id)
}

// 修改配置:使用写锁
func writeConfig(val int, wg *sync.WaitGroup) {
    defer wg.Done()
    rw.Lock()
    defer rw.Unlock()
    config = val
    fmt.Printf("写者:已将配置修改为 %d\n", config)
}

func main() {
    var wg sync.WaitGroup
    wg.Add(3)

    go writeConfig(200, &wg)
    time.Sleep(10 * time.Millisecond)    // 稍等写协程先执行
    go readConfig(1, &wg)
    go readConfig(2, &wg)

    wg.Wait()
}运行结果如下。
写者:已将配置修改为 200
读者 1:开始读取,配置为 200
读者 2:开始读取,配置为 200
读者 1:读取完毕
读者 2:读取完毕
分析:
从运行结果可以看出,当写者修改完配置释放写锁后,读者 1 和读者 2 几乎在同一时刻打印出了 "开始读取",并没有等读者 1 休眠完 50 毫秒打印 "读取完毕" 后才轮到读者 2。
这是因为 readConfig() 使用的是读锁 rw.RLock(),多个只读协程可以同时进入临界区并发读取。而 writeConfig() 使用的是独占写锁 rw.Lock(),能确保修改配置时没有其他协程同时读写。
另外小伙伴们可能会留意到,main() 函数中间加了一行 time.Sleep(10 * time.Millisecond)。这只是为了让写协程先启动改完配置,方便我们观察两个读者同时读取新值的效果。就算去掉这行休眠,读写锁本身依然能保证并发安全。
在实际开发中,如果共享变量的读写次数差不多,我们直接使用最简单的 sync.Mutex 就可以了。只有当读取次数明显多于修改次数时,小伙伴们再换用 sync.RWMutex 来提升并发读取效率。
