



在 Go 语言中,正则表达式(Regular Expression)是一套用来描述 “字符串长什么样” 的匹配规则。
前面学习的 strings.Contains() 函数只能查找固定不变的子串。借助标准库 regexp 包提供的正则表达式,我们可以按规则校验 11 位手机号码、提取文本中的所有数字,或者批量隐藏敏感字符。
判断字符串是否匹配
在 Go 语言中,使用正则表达式主要分为 2 步:① 调用 regexp.MustCompile() 将规则字符串编译成正则对象;② 调用该对象的 MatchString() 方法判断目标字符串是否符合规则。
语法:
re := regexp.MustCompile(`正则规则`)
matched := re.MatchString(目标字符串)
说明:
regexp.MustCompile() 接收一个正则表达式字符串,返回一个 *regexp.Regexp 正则对象。编写正则规则时,推荐像定义多行字符串那样使用反引号(`)包裹,这样写 \d 时就不需要对反斜杠做额外转义了。
拿到正则对象 re 后,我们调用 re.MatchString() 就可以判断目标字符串中是否包含符合规则的内容。如果匹配成功返回 true,否则返回 false。
示例 1:判断字符串是否包含数字
package main

import (
    "fmt"
    "regexp"
)

func main() {
    re := regexp.MustCompile(`\d+`)    // 匹配连续一个或多个数字
    fmt.Println(re.MatchString("hello 2026"))
    fmt.Println(re.MatchString("hello lvye"))
}运行结果如下。
true
false
分析:
在正则表达式中,\d 表示任意一个数字(0~9),后面的加号 + 表示连续出现 1 次或多次。"hello 2026" 中包含数字 "2026",调用 re.MatchString() 返回 true;而 "hello lvye" 中没有任何数字,因此返回 false。
在实际开发中,我们经常需要限制字符范围、指定出现次数,或者要求整串文本从头到尾完整匹配。这时就会用到正则表达式中的 “元字符”,常用的元字符如下表所示。
| 元字符 | 说明 | 示例 |
|---|---|---|
| \d | 匹配任意一个数字(0~9) | \d 匹配 "8" |
| \w | 匹配字母、数字或下划线 | \w 匹配 "a"、"5" |
| \s | 匹配空格、制表符等空白符 | \s 匹配 " " |
| . | 匹配除换行外的任意单字符 | a.c 匹配 "abc" |
| + | 前面的字符出现 1 次或多次 | \d+ 匹配 "123" |
| * | 前面的字符出现 0 次或多次 | ab* 匹配 "a"、"ab" |
| ? | 前面的字符出现 0 次或 1 次 | https? 匹配 "http"、"https" |
| {n} 与 {n,m} | 恰好出现 n 次或 n~m 次 | \d{4} 匹配 "2026" |
| [a-z] | 匹配方括号内的任意单字符 | [3-9] 匹配 "5" |
| ^ 与 $ | 分别匹配字符串开头与结尾 | ^\d+$ 匹配纯数字 |
需要注意的是,点号(.)、加号(+)、问号(?)等符号在正则中具有特殊含义。如果我们只是想匹配普通的英文句点本身,比如匹配域名中的点号,就需要在前面加上反斜杠写成 \. 才行。
这里顺便提一点:Go 语言的 regexp 包底层采用 RE2 引擎,好处是匹配速度稳定、不会因为复杂表达式陷入死循环卡死。但它不支持其他语言里常见的 “前瞻 / 后顾” 语法(如 (?=...)),如果从网上复制的复杂密码校验正则在 Go 里报错,多半就是用到了这类语法。
结合上面的元字符,下面我们来看一个实际开发中经常用到的例子:校验用户输入的字符串是不是合法的 11 位手机号码。
示例 2:校验 11 位手机号码
package main

import (
    "fmt"
    "regexp"
)

func main() {
    re := regexp.MustCompile(`^1[3-9]\d{9}$`)

    fmt.Println(re.MatchString("13800138000"))       // 合法手机号
    fmt.Println(re.MatchString("12345"))             // 位数不够
    fmt.Println(re.MatchString("abc13800138000"))    // 开头混有字母
}运行结果如下。
true
false
false
分析:
我们把正则规则 ^1[3-9]\d{9}$ 拆开来看:开头的 ^ 和结尾的 $ 表示整串文本从头到尾必须完全符合规则。
在中间的规则里,第 1 位固定是数字 1,第 2 位 [3-9] 表示 3 到 9 之间的任意一个数字,后面的 \d{9} 表示紧跟 9 个数字。这三部分合起来正好是 11 位手机号码,因此 "13800138000" 返回 true,而位数不够的 "12345" 返回 false。
这里要特别留意,如果去掉开头的 ^ 和结尾的 $,只要字符串局部包含一段 11 位手机号(如 "abc13800138000"),MatchString() 同样会返回 true。因此在校验手机号、邮箱这类完整格式时,小伙伴们记得一定要加上 ^ 和 $ 限制首尾。
注意: 在 Go 语言中编写正则表达式时,我们建议统一使用反引号(`)包裹,比如写成 regexp.MustCompile(`\d+`)。如果改用双引号,直接写 "\d+" 会触发未知转义序列报错,必须写成双反斜杠 "\\d+" 才能通过编译。
提取匹配的字符串
除了判断字符串 “是否符合规则” 之外,我们在实际开发中还经常需要从一段文字里把符合规则的内容提取出来。这时可以使用正则对象的 FindString() 或 FindAllString() 方法。
语法:
first := re.FindString(目标字符串)
all := re.FindAllString(目标字符串, n)
说明:
re.FindString() 只会提取目标字符串中出现的第 1 个匹配项,返回一个 string。如果没有找到匹配内容,则返回空字符串 ""。
re.FindAllString() 用于提取多个匹配项,返回一个字符串切片 []string。它的第 2 个参数 n 用来限制最多提取几个匹配项。如果我们想把所有符合规则的内容全部找出来,直接将该参数填为 -1 即可。
示例 3:提取文本中的数字
package main

import (
    "fmt"
    "regexp"
)

func main() {
    text := "订单 1001 金额 250 元,订单 1002 金额 380 元"
    re := regexp.MustCompile(`\d+`)

    first := re.FindString(text)         // 只提取第 1 个匹配项
    all := re.FindAllString(text, -1)    // 提取全部匹配项

    fmt.Println("first =", first)
    fmt.Println("all =", all)
}运行结果如下。
first = 1001
all = [1001 250 1002 380]
分析:
re.FindString(text) 从左往右查找,遇到第 1 处连续数字 "1001" 后就立即返回。而 re.FindAllString(text, -1) 会把整段文本扫描到底,将找到的 4 处数字全部装进切片 [1001 250 1002 380] 中返回。
对于这个例子来说,如果我们将 re.FindAllString(text, -1) 的第 2 个参数改为正整数 2,程序就只会提取前 2 个匹配到的数字并返回 [1001 250]。
在使用 .* 或 .+ 提取成对标签里的内容时,为什么有时会把中间无关的文字也一起吞进去呢?这其实涉及到正则表达式中 “贪婪匹配” 与 “非贪婪匹配” 的区别,下面我们来看一个例子。
示例 4:贪婪匹配与非贪婪匹配
package main

import (
    "fmt"
    "regexp"
)

func main() {
    html := "<b>Go</b> 和 <b>Python</b>"

    reGreedy := regexp.MustCompile(`<b>.*</b>`)    // 默认贪婪匹配
    reLazy := regexp.MustCompile(`<b>.*?</b>`)     // 加 ? 开启非贪婪匹配

    fmt.Println("贪婪模式 =", reGreedy.FindAllString(html, -1))
    fmt.Println("非贪婪模式 =", reLazy.FindAllString(html, -1))
}运行结果如下。
贪婪模式 = [<b>Go</b> 和 <b>Python</b>]
非贪婪模式 = [<b>Go</b> <b>Python</b>]
分析:
默认情况下,* 和 + 都是 “贪婪” 的,会尽可能往后多匹配字符。所以 <b>.*</b> 会从第 1 个 <b> 一路匹配到整句话最后的 </b>,把中间的 " 和 " 也一并包了进去,最终只提取出 1 整段。
我们在 * 后面加上问号写成 .*?,就开启了 “非贪婪模式”。一旦遇到第 1 个能配对的 </b> 就会立即收手,从而准确提取出 <b>Go</b> 和 <b>Python</b> 两项内容。平时提取 HTML 标签或引号内文本时,小伙伴们记得优先使用 .*?。
提示: 编译正则表达式本身有一定的性能开销。如果我们需要在循环中反复匹配大量文本,记得把 regexp.MustCompile() 放在循环外部只编译一次、重复使用,不要在每次循环内部重复编译。
提取括号分组内容
有时候我们不仅想匹配出整段特定格式的文本,还想把日期 "2026-10-26" 里面的 “年”、“月”、“日” 单独拆出来。这时可以在正则表达式里使用圆括号 () 把需要单独提取的部分括起来,再调用 re.FindStringSubmatch() 方法。
语法:
match := re.FindStringSubmatch(目标字符串)说明:
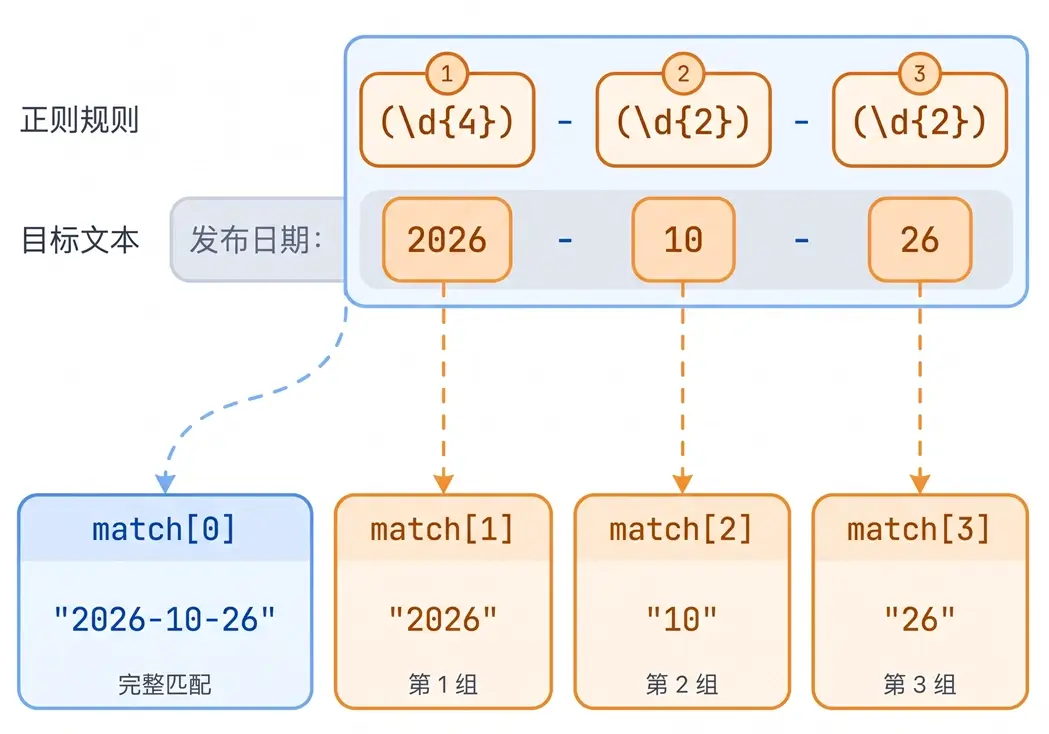
如果目标字符串没有匹配成功,re.FindStringSubmatch() 会返回空切片。匹配成功时,返回的 []string 切片中下标 0(match[0])固定保存完整匹配到的整段文本,而 match[1]、match[2] 则依次对应各个圆括号 () 捕获到的子内容,如下图所示。
示例 5:提取日期中的年月日
package main

import (
    "fmt"
    "regexp"
)

func main() {
    str := "发布日期:2026-10-26"

    // 使用 3 对圆括号分别捕获年、月、日
    re := regexp.MustCompile(`(\d{4})-(\d{2})-(\d{2})`)
    match := re.FindStringSubmatch(str)

    if len(match) > 0 {
        fmt.Printf("完整匹配:%s\n", match[0])
        fmt.Printf("年:%s\n", match[1])
        fmt.Printf("月:%s\n", match[2])
        fmt.Printf("日:%s\n", match[3])
    }
}运行结果如下。
完整匹配:2026-10-26
年:2026
月:10
日:26
分析:
在正则规则 (\d{4})-(\d{2})-(\d{2}) 中,我们使用了 3 对圆括号。匹配成功后,match[0] 保存整段结果 "2026-10-26",而 match[1] 到 match[3] 则依次对应 3 对圆括号捕获到的 "2026"、"10" 和 "26"。
需要注意的是,如果目标字符串里没有符合规则的日期,FindStringSubmatch() 返回的切片长度为 0。因此在读取 match[1] 等分组内容前,小伙伴们一定要先判断 len(match) > 0,防止直接按下标访问触发越界报错。
此外,如果一段文本里包含多处日期,我们可以调用 re.FindAllStringSubmatch(str, -1) 一次性提取所有日期的分组内容。该方法会返回一个二维字符串切片 [][]string。
替换匹配的字符串
前面学过的 strings.ReplaceAll() 只能替换固定的子串。如果我们想把文本中所有符合正则规则的部分统一替换成新内容,比如隐藏电话号码或验证码,可以使用 re.ReplaceAllString() 方法。
语法:
result := re.ReplaceAllString(原字符串, 替换后的新字符串)说明:
re.ReplaceAllString() 会将原字符串中所有匹配正则规则的部分替换成新字符串,并返回一个替换后的新字符串,原字符串本身不会被修改。
示例 6:隐藏文本中的数字
package main

import (
    "fmt"
    "regexp"
)

func main() {
    s := "我的电话是 13800138000,验证码是 6688"
    re := regexp.MustCompile(`\d+`)

    res := re.ReplaceAllString(s, "***")
    fmt.Println(res)
}运行结果如下。
我的电话是 ***,验证码是 ***分析:
re.ReplaceAllString(s, "***") 表示找出字符串 s 中所有连续的数字 "13800138000" 和 "6688",并将它们统一替换成 "***"。
在实际业务里,我们给手机号脱敏时通常希望保留前 3 位和后 4 位,只把中间 4 位藏起来。这时可以配合圆括号分组,在替换字符串中用 $1 和 $2 引用保留下来的部分,代码如下:
rePhone := regexp.MustCompile(`(\d{3})\d{4}(\d{4})`)
// 替换后结果为 "138****8000"
masked := rePhone.ReplaceAllString("13800138000", "$1****$2")
此外,如果想按一个或多个空白字符 \s+ 切分字符串,我们也可以调用正则对象的 re.Split(s, -1) 方法,它的用法和前面学过的 strings.Split() 非常相似。
Compile() 与 MustCompile() 的区别
在 regexp 包中,编译正则表达式其实提供了 Compile() 和 MustCompile() 两个函数。在 Go 标准库里,以 Must 开头的函数都代表 “必须成功,否则直接触发 panic”:
- regexp.MustCompile():适合我们在代码里写好的固定正则规则。它省去了每次判断
err的步骤,一旦规则写错,程序启动时就会立即暴露问题。 - regexp.Compile():会返回
(*Regexp, error)两个值,不会触发panic。当正则规则是由用户在网页或配置文件中动态输入时,我们应该使用Compile()并检查返回的错误。
