



在没有泛型之前,如果我们想写一个计算两个整数相加的 addInt() 函数,以及一个计算两个小数相加的 addFloat() 函数,代码通常要写成下面这样:
func addInt(a, b int) int {
    return a + b
}

func addFloat(a, b float64) float64 {
    return a + b
}
可以看到,这两个函数内部的计算步骤一模一样,都是执行 return a + b。仅仅因为参数和返回值的类型不同,我们就不得不把相似的代码重复写好几遍。
为了解决这类重复编写代码的问题,Go 1.18 引入了 “泛型(Generics)”。简单来说,泛型就是让我们在定义函数或类型时,先使用一个符号给数据类型当 “占位符”,等到真正使用时再确定具体的类型。
Go 泛型主要包含泛型函数和泛型类型两部分,这一节我们先从最常用的泛型函数学起。
Go 泛型函数的定义
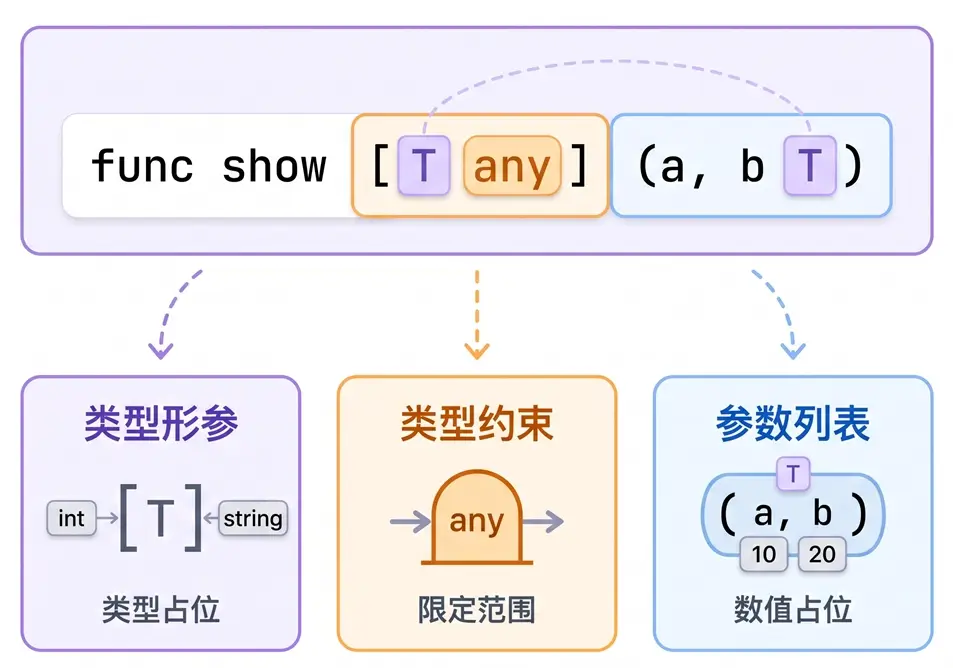
在 Go 语言中,我们可以把泛型函数跟普通的函数对比着来理解。普通函数只有一个小括号 (a, b int),用来给 “具体数值” 占位置。而泛型函数在函数名和小括号之间多了一对方括号(如 [T any]),专门用来给 “数据类型” 占位置,如下图所示。
语法:
func 函数名[T 类型约束](参数列表) 返回值类型 {
    // 函数体
}
说明:
方括号中的 T 叫做 “类型形参”,也就是数据类型的占位符。在实际开发中,我们通常习惯使用单个大写字母 T、K、V 来命名,其中 T 是英文 “Type(类型)” 的首字母。
T 后面的 “类型约束” 用来规定 T 允许传入哪些数据类型。如果我们希望 T 能够接收任意类型,可以直接使用上一章学过的空接口 any,写成 [T any]。在定义泛型函数时,需要注意以下 2 点:
- 函数名后面紧跟声明类型形参的方括号,随后再接普通参数列表的小括号。
- 在后面的普通参数列表、返回值以及函数体内部,我们可以直接把
T当成普通的数据类型来使用。
示例 1:打印任意类型的切片
package main

import "fmt"

// 打印任意类型的切片
func printSlice[T any](s []T) {
    for _, v := range s {
        fmt.Printf("%v ", v)
    }
    fmt.Println()
}

func main() {
    nums := []int{10, 20, 30}
    names := []string{"C", "Go", "Python"}

    printSlice(nums)
    printSlice(names)
}运行结果如下。
10 20 30
C Go Python
分析:
在这个例子中,我们定义了泛型函数 printSlice[T any](s []T)。其中,方括号里的 T 是类型占位符,any 表示允许任意类型,而 s []T 表示接收一个元素类型为 T 的切片。
当我们在 main() 中传入 []int 类型的 nums 时,T 会自动对应为 int。当我们传入 []string 类型的 names 时,T 又会自动对应为 string,这样只写一个函数就能打印不同类型的切片了。
注意: 定义泛型函数时,方括号里的每一个类型形参后面都必须写明类型约束。哪怕允许接收任意类型,我们也必须完整写成 [T any],不能只写一个 [T],否则编译时会直接报错。
如果现在想把文章开头那两个加法函数合并成一个泛型函数,能不能继续写成 [T any] 呢?答案是不行的。因为 any 包含切片、布尔值等不支持 + 号的类型,直接写 a + b 会触发编译报错。
为了让编译器确定传入的类型一定支持加法运算,我们可以在方括号里使用竖线(|)列出允许的数字类型,写成 [T int | float64]。其中竖线表示 “或者” 的意思,下面我们来看具体的实现代码。
示例 2:通用的加法函数
package main

import "fmt"

// 限定 T 只能是 int 或 float64 类型
func add[T int | float64](a, b T) T {
    return a + b
}

func main() {
    fmt.Println(add(10, 20))
    fmt.Println(add(1.5, 2.3))
}运行结果如下。
30
3.8
分析:
func add[T int | float64](a, b T) T 限定了 T 只能是 int 或 float64 类型。这两种类型都支持 + 号运算,因此函数体内部可以直接执行 return a + b。关于限制类型范围的更多写法,后面学习泛型约束时还会详细介绍。
这里小伙伴们还要注意一点:在 add(a, b T) 中,参数 a 和 b 的类型都是同一个 T。这意味着在同一次调用中,传入的两个变量必须是同一种类型,不能传一个 int 变量加一个 float64 变量。
n := 10
f := 1.5

// 正确方式
fmt.Println(add(n, 20))

// 错误方式
fmt.Println(add(n, f))
在上面的错误方式中,第 1 个实参 n 已经把类型占位符 T 确定为 int 类型。此时第 2 个实参再传入 float64 类型的变量 f,编译器就会直接报错提示类型不匹配。
类型推断与指定类型
定义泛型函数时函数名后面明明带有方括号,为什么前面调用 add(10, 20) 时却把方括号省掉了呢?其实,这是因为 Go 编译器根据传入的参数帮我们自动推断出了具体类型。
在调用泛型函数时,我们既可以让编译器自动推断类型,也可以在函数名后面的方括号里显式写出 “类型实参”(如 div[float64](5, 2)),与定义时的 “类型形参” T 一一对应。下面我们通过一个除法例子来对比这两种调用方式。
示例 3:自动推断与指定类型
package main

import "fmt"

func div[T int | float64](a, b T) T {
    return a / b
}

func main() {
    // 1. 自动推断为 int 类型
    fmt.Println(div(5, 2))

    // 2. 显式指定为 int 类型
    fmt.Println(div[int](5, 2))

    // 3. 显式指定为 float64 类型
    fmt.Println(div[float64](5, 2))
}运行结果如下。
2
2
2.5
分析:
当我们调用 div(5, 2) 传入两个整数常量时,Go 编译器默认会把无类型整数常量 5 和 2 推断为 int 类型,按整数除法截断小数得到 2。因此对于 int 类型来说,下面 2 种调用方式是等价的。
// 方式 1(推荐)
r1 := div(5, 2)

// 方式 2
r2 := div[int](5, 2)
在日常开发中,只要编译器能从普通实参推断出准确的类型,我们优先使用方式 1 省去方括号即可,代码更加简洁。
那什么时候才需要像方式 2 那样显式写出方括号呢?主要有以下 2 种情况:
- 指定按特定类型计算常量:比如示例中的
div[float64](5, 2),显式将T指定为float64后,整数常量 5 和 2 就会按小数相除,顺利保留小数得到 2.5。 - 普通参数列表里没有用到 T:比如无参函数
func zeroVal[T any]() T,由于没有任何实参可供编译器推断类型,调用时就必须显式写成zeroVal[int]()。
提示: 其实在前面的切片章节中,小伙伴们已经用过标准库提供的泛型函数了。比如 slices.Contains() 和 slices.Sort() 之所以能直接传入整数切片或字符串切片而不用写方括号,底层正是依靠泛型和类型推断实现的。
声明多个类型形参
前面的例子都只声明了一个类型占位符 T。如果一个函数需要同时接收多种不同类型的数据(比如一个键和一个值),我们也可以在方括号里声明多个类型形参,中间使用英文逗号(,)隔开。
示例 4:声明多个类型形参
package main

import "fmt"

// 包含 K 和 V 两个类型形参
func printPair[K, V any](key K, val V) {
    fmt.Printf("%v: %v\n", key, val)
}

func main() {
    printPair("语言", "Go")
    printPair("成绩", 95)
}运行结果如下。
语言: Go
成绩: 95
分析:
printPair() 函数在方括号中定义了 K 和 V 两个独立的类型占位符。当我们第 1 次调用时,K 和 V 都对应 string;当我们第 2 次调用时,K 对应 string、V 对应 int,两者互不干扰。
跟普通函数的参数列表一样,当相邻多个类型形参的约束相同时,下面 2 种声明写法是等价的。
// 方式 1(推荐)
func printPair[K, V any](key K, val V) {
    fmt.Printf("%v: %v\n", key, val)
}

// 方式 2
func printPair[K any, V any](key K, val V) {
    fmt.Printf("%v: %v\n", key, val)
}
其中,方式 1 把相同的 any 约束合并在了最后,写起来更加紧凑。如果两个类型形参的约束不同,再分别写明各自的约束即可(如 [K int | string, V any])。
常见问题
1. 前面学过的空接口 any 也能接收任意类型的参数,泛型和空接口有什么区别?
虽然空接口和泛型都能处理不同类型的数据,但泛型在实际开发中有以下 2 个明显的优势:
- 编译阶段检查类型,无需类型断言:比如泛型函数
add[T int | float64](a, b T) T,编译器会保证传入的实参是同一种数字类型,返回值也是原本的类型。如果改用空接口,不仅无法在编译期阻止整数和字符串相加,返回值还得先做类型断言才能继续参与计算。 - 运行效率更高:泛型在程序编译阶段就已经确定了具体的数据类型,运行时不需要像空接口那样动态包装和解析类型信息,因此执行速度更快。
2. 平时写代码时,遇到什么情况才需要自己编写泛型函数?
刚开始接触泛型时,小伙伴们不需要一上来就把所有函数都写成泛型。如果一个函数只处理某一种固定的类型,比如只处理字符串或某一个结构体,直接写普通函数反而更直观好读。
只有当我们发现好几个函数的内部处理步骤完全一样、仅仅是参数或返回值的数据类型不同时,再把它们提取合并成一个泛型函数就可以了。
