



在 Go 语言中,所谓的 “字符串反转”,指的就是把字符串中的字符顺序从后往前倒过来排列。例如把 "Hello" 变成 "olleH",把 "绿叶网" 变成 "网叶绿"。
由于标准库的 strings 包没有提供现成的反转函数,而字符串本身又是不可变的,我们可以先把它转换为 []rune 字符切片再处理。常用的实现方式有 2 种:一种是调用 slices.Reverse() 函数,另一种是使用 for 循环首尾交换字符。
slices.Reverse() 反转(推荐)
从 Go 1.21 开始,标准库新增了 slices 包,里面提供了现成的 slices.Reverse() 函数。其中 reverse 在英文中是 “反转、倒序” 的意思,它可以把切片里的元素顺序原地倒过来。
因此,实现字符串反转只需要简单的 3 步:先把字符串转为 rune 切片,调用 slices.Reverse() 反转切片元素,最后再通过 string() 转回字符串即可。
语法:
runes := []rune(s)
slices.Reverse(runes)
rev := string(runes)
说明:
为什么这里要转换为 []rune 切片,而不是 []byte 字节切片呢?因为转为 []rune 后,无论是英文字母还是中文汉字都会作为一个完整的字符参与反转,不会出现中文乱码。
示例 1:反转中英文字符串
package main

import (
    "fmt"
    "slices"
)

func main() {
    s := "Hello, 绿叶网"

    runes := []rune(s)       // 转为 []rune 切片
    slices.Reverse(runes)    // 原地反转切片元素
    rev := string(runes)     // 重新转回 string 类型

    fmt.Println(rev)
}运行结果如下。
网叶绿 ,olleH分析:
[]rune(s) 先把中英文混合字符串拆成字符切片,接着 slices.Reverse(runes) 将切片中的字符顺序从后往前倒过来,最后 string(runes) 把反转后的切片转换为新字符串 "网叶绿 ,olleH"。
注意: slices.Reverse(runes) 会在原切片上原地修改元素顺序,函数本身没有返回值。小伙伴们调用时单独写一行 slices.Reverse(runes) 即可,不能写成 res := slices.Reverse(runes),否则编译报错。
如果我们在反转包含中文的字符串时,误用了 []byte 字节切片,会发生什么情况呢?下面我们通过一个例子来看看。
示例 2:误用 []byte 反转中文乱码
package main

import (
    "fmt"
    "slices"
)

func main() {
    s := "学Go"
    bytes := []byte(s)       // 误转为 []byte 字节切片
    slices.Reverse(bytes)    // 按单字节倒序排列
    fmt.Println(string(bytes))
}运行结果如下。
oG���分析:
汉字 '学' 在底层是由 3 个字节按固定顺序组合而成的。当我们使用 []byte("学Go") 并调用 slices.Reverse(bytes) 时,英文字母正常倒序成了 "oG",但汉字 '学' 内部那 3 个字节的顺序也被倒了过来。
顺序颠倒后的字节不再符合 UTF-8 编码规则,打印出来就变成了乱码替换符。因此,小伙伴们在反转可能包含中文的字符串时,一定要记得使用 []rune 切片。
for 循环首尾交换反转
除了调用 slices.Reverse() 函数之外,在练习基础算法或阅读早期项目代码时,我们还会见到使用 for 循环手动交换首尾字符的写法。实际上,这也是 slices.Reverse() 内部的实现思路。
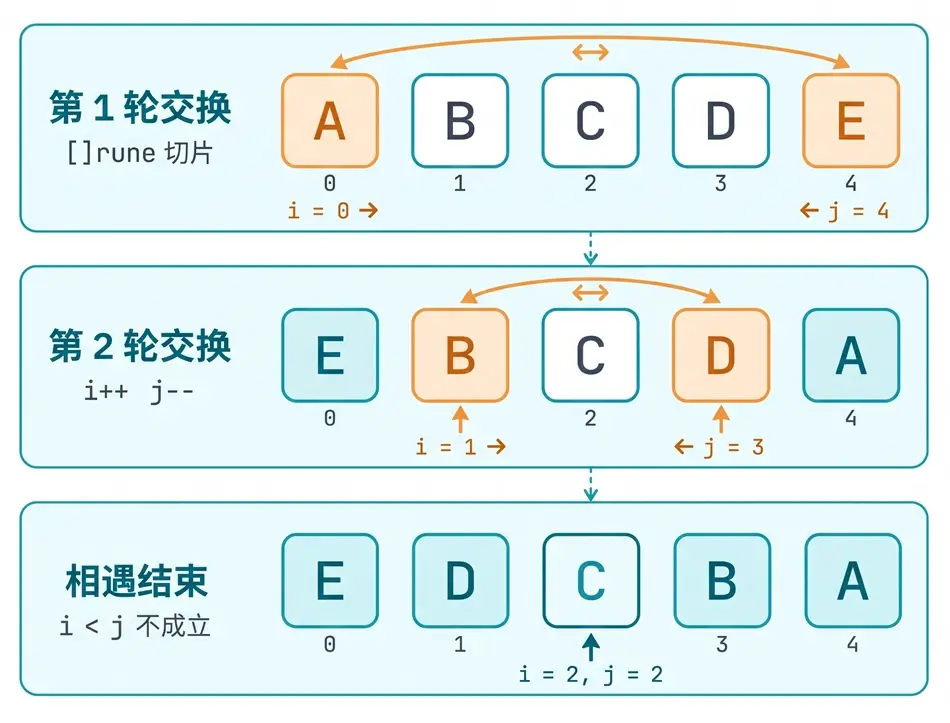
它的过程非常直观:先把字符串转为 []rune 切片,让左下标 i 从 0 开始往右走,右下标 j 从末尾 len(runes) - 1 开始往左走。每次循环把首尾两个位置的字符对调,直到 i 和 j 在中间相遇为止,如下图所示。
示例 3:首尾交换字符实现反转
package main

import "fmt"

func main() {
    s := "ABCDE"
    runes := []rune(s)

    i := 0                 // 左下标从第 1 个元素开始
    j := len(runes) - 1    // 右下标从最后一个元素开始
    for i < j {
        // 交换首尾两个位置的字符
        runes[i], runes[j] = runes[j], runes[i]
        i++                // 左下标右移 1 位
        j--                // 右下标左移 1 位
    }

    fmt.Println(string(runes))
}运行结果如下。
EDCBA分析:
在这个例子中,切片 runes 的初始元素为 ['A', 'B', 'C', 'D', 'E'],长度为 5。循环过程中每一轮的状态变化如下:
- 第 1 轮循环:
i = 0、j = 4,交换runes[0]和runes[4],切片变为['E', 'B', 'C', 'D', 'A']。随后i变为 1,j变为 3。 - 第 2 轮循环:
i = 1、j = 3,交换runes[1]和runes[3],切片变为['E', 'D', 'C', 'B', 'A']。随后i变为 2,j变为 2。
当 i 和 j 都变为 2 时,条件 i < j 不再成立,循环结束。正中间的 'C' 保持原位不动,最终输出 "EDCBA"。因为提前转成了 []rune 切片,哪怕把 "ABCDE" 换成 "绿叶网学Go",这套循环代码也照样能正常反转、不会乱码。
其中,runes[i], runes[j] = runes[j], runes[i] 利用了 Go 语言的多变量同时赋值特性,一行代码就能互换两个元素的值,不需要额外定义临时变量中转。
此外,我们也可以把左、右下标的初始化和移动合并写进 for 循环头部。对于这个例子来说,下面 2 种写法是等价的。
// 写法 1(推荐)
i := 0
j := len(runes) - 1
for i < j {
    runes[i], runes[j] = runes[j], runes[i]
    i++
    j--
}

// 写法 2
for i, j := 0, len(runes)-1; i < j; i, j = i+1, j-1 {
    runes[i], runes[j] = runes[j], runes[i]
}
其中,写法 1 把下标的初始化和移动拆开书写,逻辑更清晰,平时自己写代码时推荐使用写法 1;写法 2 小伙伴们在阅读他人代码时能认出来即可。如果是日常项目开发(Go 1.21 及以上版本),直接调用 slices.Reverse() 函数最为省心。
