



平时我们都是在 main() 等函数里面去调用其他函数。如果一个函数在它自己的函数体内部又调用了它自己,这个函数就叫做 “递归函数(recursive function)”。
递归的执行过程很像拆装 “俄罗斯套娃”:先一层层打开大套娃,直到看见最里面不能再拆的小木偶,再从里往外一层层合拢装回去。
递归函数的语法与条件
为了保证递归函数能够正常停下来,不会像死循环那样一直跑下去,我们在编写递归函数时必须同时满足以下 2 个条件:
- 具备明确的终止条件:我们在函数开头通常先用 if 语句判断什么时候停下来。一旦满足终止条件,就直接返回确定结果,不再继续调用自己。
- 参数向终止条件靠近:每次调用自身时,传入的参数不能原地踏步,必须一步步往终止条件的方向变化,这样才能在有限次调用后顺利停下来。
语法:
func 函数名(参数 类型) 返回值类型 {
    if 终止条件 {
        return 基础结果
    }
    return 函数名(变化后的参数)
}
说明:
写递归函数时,进入函数体的第一件事就是先写好 if 终止条件,把最简单的基础情况直接返回。如果不满足终止条件,再改变参数继续调用函数自身。
注意: 在递归调用自身时,千万不要把原参数原样传回去。比如在 sum(n) 内部直接写 sum(n),参数就永远到不了终止条件,程序会一直死循环调用下去。
递归函数示例
下面我们从最基础的 “数字累加” 入手,看看递归函数在运行过程中是怎么一步步算出结果的。
示例 1:计算 1 到 n 的累加和
package main

import "fmt"

// 计算 1 到 n 的累加和
func sum(n int) int {
    if n == 1 {
        return 1
    }
    return n + sum(n-1)
}

func main() {
    res := sum(4)
    fmt.Println(res)
}运行结果如下。
10分析:
return n + sum(n-1) 这句代码的意思很直观:要想算出 1 到 n 的总和,只需要用当前的数字 n 加上 “1 到 n-1 的总和” 就可以了。而且每次调用 sum() 时,系统都会单独开辟一小块内存来存当前这一层的参数 n,各层之间的 n 互不干扰。
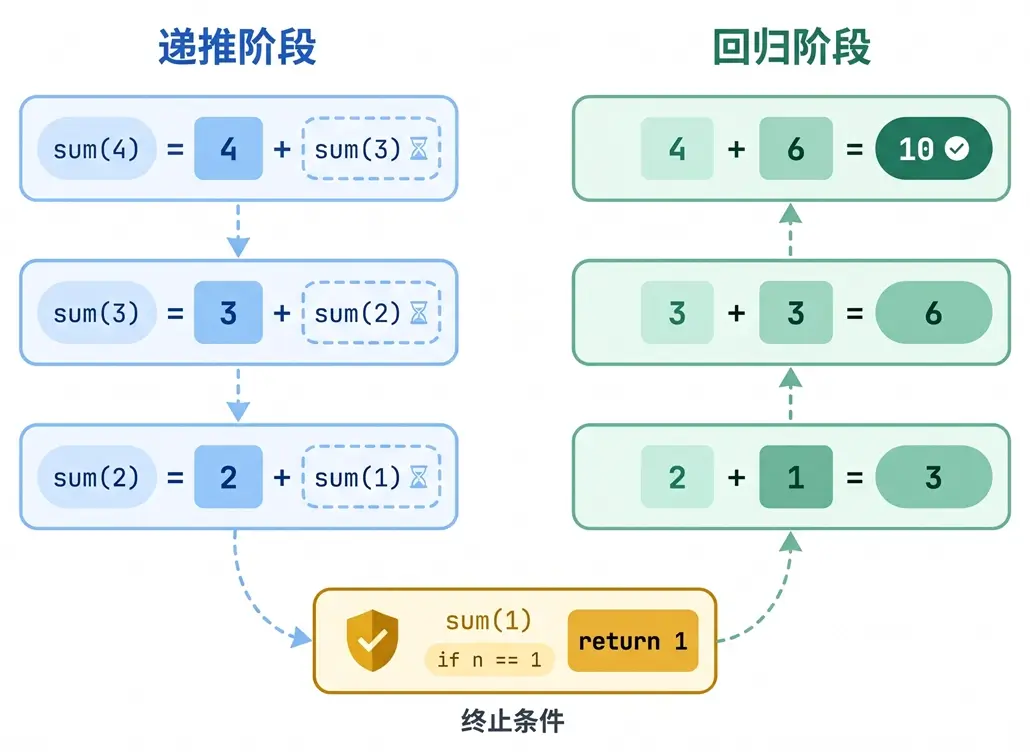
当 sum(4) 执行到 return 4 + sum(3) 时,明明已经遇到 return 了,为什么函数没有立刻结束呢?这是因为加号右边的 sum(3) 还没算出具体数值,sum(4) 只能先停在这里等待 sum(3) 的结果。往下逐层展开的过程如下:
sum(4) = 4 + sum(3)
sum(4) = 4 + (3 + sum(2))
sum(4) = 4 + (3 + (2 + sum(1)))
当程序一路往下调用到 sum(1) 时,满足了 n == 1 的终止条件并直接返回 1。拿到确定的数值 1 之后,前面暂停等待的每一层就开始从里往外逐层相加返回:
sum(4) = 4 + (3 + (2 + 1))
sum(4) = 4 + (3 + 3)
sum(4) = 4 + 6
sum(4) = 10
可以看到,整个执行过程分为两个阶段:先是一层层往下调用自身的 “递推” 阶段,遇到终止条件后再逐层往回算结果的 “回归” 阶段,这也是 “递归” 这个名字的由来。sum(4) 的完整执行流程如下图所示。
如果小伙伴们想亲眼看看这个 “先钻进去、再退出来” 的顺序,可以试着在 sum() 递归调用的前后各加一行打印 n 的代码,运行后观察控制台输出就一目了然了。
另外在实际写这类累加函数时,我们通常会把终止条件写成 if n <= 0 { return 0 },防止误传 0 或负数时跨过终止条件。
除了累加求和之外,数学上的正整数 “阶乘” 也是递归的常见例子。一个正整数 n 的阶乘表示从 1 乘到 n 的积,比如 5 的阶乘就是 120(即 5 * 4 * 3 * 2 * 1)。
示例 2:计算 n 的阶乘
package main

import "fmt"

// 计算 n 的阶乘
func factorial(n int) int {
    if n <= 1 {
        return 1
    }
    return n * factorial(n-1)
}

func main() {
    fmt.Println(factorial(5))
}运行结果如下。
120分析:
在这个例子中,调用 factorial(5) 后,每次往里调用 factorial(n-1) 时参数 n 都会减 1,一步步靠近终止条件 n <= 1。等 n 减小到 1 时直接返回 1,随后再逐层往回相乘得出 120。
为什么这里的终止条件写成了 n <= 1,而不是 n == 1 呢?因为在数学上 0 的阶乘也等于 1,这样写除了能正常处理 0 之外,还能防止调用时误传负数而跨过终止条件,避免陷入无限递归。
无限递归与栈溢出
如果在写递归函数时漏掉了终止条件,程序跑起来会发生什么情况呢?下面我们来看一个反面例子。
示例 3:缺少终止条件导致报错
package main

func countDown(n int) {
    countDown(n - 1)    // 缺少终止条件
}

func main() {
    countDown(3)
}
运行结果如下。
(报错)runtime: goroutine stack exceeds 1000000000-byte limit
fatal error: stack overflow
分析:
在计算机底层,每调用一次函数且还没返回时,系统都需要分配一小块叫做 “栈(stack)” 的临时内存,用来保存当前这一层函数的数据。
上面代码中的 countDown() 漏写了终止条件,会不停地调用自己,很快就把栈内存占满,最终报 stack overflow(栈溢出)错误导致程序崩溃。想要修复这个问题,我们只需在函数开头补上判断,让递归在 n <= 0 时通过 return 语句及时退出就可以了。
func countDown(n int) {
    if n <= 0 {
        return
    }
    fmt.Println(n)
    countDown(n - 1)
}
补上终止条件和打印语句后,调用 countDown(3) 就会依次输出 3、2、1 并正常结束,不会再出现栈溢出。
在实际开发中,对于累加求和、求阶乘这类简单的数学计算,我们直接使用前面学过的 for 循环写起来更直观,执行速度也更快、更省内存。递归真正好用的地方是处理层级深度不固定的树形结构,比如逐层扫描嵌套的多级文件夹,小伙伴们根据实际场景灵活选用即可。
