



在 Go 语言中,很多初学的小伙伴在统计字符串长度时都会遇到一个奇怪的现象:调用 len("Go") 得到的结果是 2,但调用 len("Go语言") 得到的结果却是 8,而不是肉眼看到的 4。
为什么会出现这种差异呢?这是因为 Go 字符串底层是一串 UTF-8 编码的字节序列,统计长度时我们需要区分 “字节数” 和 “字符个数” 这两种情况。
获取字节数
与获取切片长度一样,字符串也可以使用内置的 len() 函数。不过在字符串中,len() 获取的是底层占用的字节数量(byte 个数),而不是字符个数。
语法:
len(s)说明:
参数 s 是要统计的字符串,len(s) 会返回一个 int 类型的整数。在 UTF-8 编码规则下,不同字符占用的字节数是不一样的:
- 每一个英文字母、数字、英文空格或英文半角符号,固定占用 1 个字节。
- 每一个常用的中文汉字或中文全角标点,占用 3 个字节。
示例 1:使用 len() 获取字节数
package main

import "fmt"

func main() {
    s1 := "Hello"
    s2 := "Go语言"

    fmt.Println(len(s1))    // 纯英文字符串
    fmt.Println(len(s2))    // 含中文字符串
}运行结果如下。
5
8
分析:
len(s1) 的结果为 5,因为 "Hello" 由 5 个英文字母组成,每个字母占 1 个字节,此时字节数刚好等于字符个数。
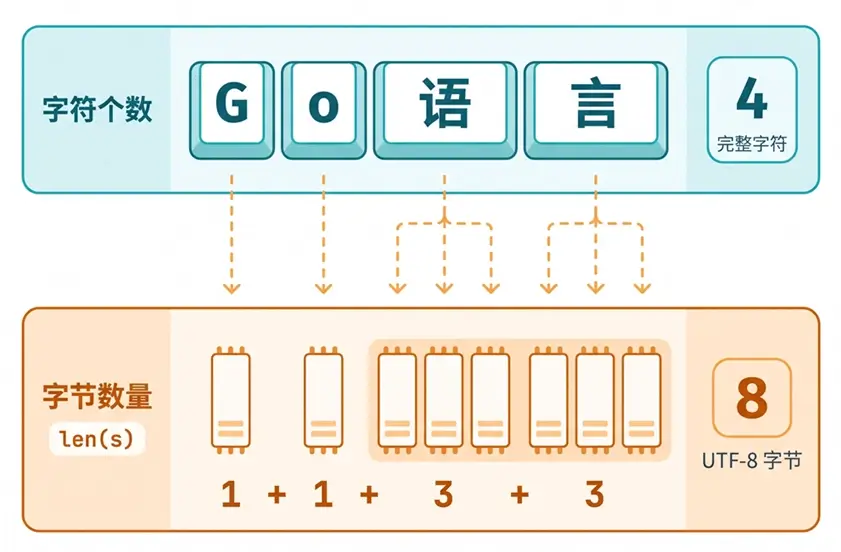
而在 s2 := "Go语言" 中,'G' 和 'o' 各占 1 个字节,'语' 和 '言' 各占 3 个字节,因此 len(s2) 算出的总字节数是 1 + 1 + 3 + 3 = 8。两者的对应关系如下图所示。
另外,空字符串 "" 没有任何字符,len("") 的结果是 0;中文全角标点(如 ,、。)与汉字一样各占 3 个字节。
统计真实字符数(推荐)
如果字符串中包含中文汉字,我们想要统计它真正包含几个字符,应该怎么做呢?在 Go 语言中,单个完整的 Unicode 字符是使用 rune 类型来表示的。
我们可以导入标准库的 "unicode/utf8" 包,调用 utf8.RuneCountInString() 函数来统计真实的字符个数。这里导入路径带有斜杠,我们在代码里调用函数时,直接使用末尾的包名 utf8 即可。
语法:
utf8.RuneCountInString(s)说明:
函数名 RuneCountInString 从英文意思上就很好记,表示 “统计字符串中 rune 字符的数量”。不管是占 1 个字节的英文字母,还是占 3 个字节的中文汉字,该函数都会把每一个完整的文字算作 1 个字符。
示例 2:统计真实字符个数
package main

import (
    "fmt"
    "unicode/utf8"
)

func main() {
    s1 := "Hello"
    s2 := "Go语言"

    fmt.Println(utf8.RuneCountInString(s1))
    fmt.Println(utf8.RuneCountInString(s2))
}运行结果如下。
5
4
分析:
从运行结果可以看出,调用 utf8.RuneCountInString(s2) 后,"Go语言" 中的两个英文字母和两个中文汉字都按完整字符计数,准确返回了字符个数 4。
注意: 校验用户昵称字数时(如限制最多 10 个字),千万不要写成 len(name) <= 10。因为 4 个汉字就会占满 12 个字节,很容易误判超长,小伙伴们记得使用 utf8.RuneCountInString(name)。
转为 []rune 切片统计
除了调用 utf8.RuneCountInString() 函数之外,我们还可以先把字符串转换为 rune 切片,再通过 len() 获取切片的元素个数。
语法:
len([]rune(s))说明:
[]rune(s) 会将字符串 s 按完整的 Unicode 字符拆分成一个 rune 切片,外层的 len() 则返回该切片包含的元素个数。
示例 3:转为 []rune 统计字符数
package main

import "fmt"

func main() {
    s := "绿叶网学Go"
    charCount := len([]rune(s))    // 转为 []rune 切片后统计长度
    fmt.Println(charCount)
}运行结果如下。
6分析:
[]rune(s) 表示把 "绿叶网学Go" 中的 4 个汉字和两个英文字母拆成 6 个独立的 rune 元素,再通过 len() 算出元素个数为 6。
既然 len([]rune(s)) 写起来更短,为什么平时更推荐 utf8.RuneCountInString() 呢?因为 []rune(s) 会复制原字符串并分配新切片内存,而 utf8.RuneCountInString() 直接在原字符串上统计,执行效率更高。
常见问题
1. 为什么在 Go 语言中一个常用汉字占 3 个字节,而不是 2 个字节?
这是因为不同编程语言底层采用的字符编码标准不同。早期的一些系统或语言内部采用 GBK 或 UTF-16 编码,一个常用汉字通常占 2 个字节。
Go 语言是由 UTF-8 编码的联合设计者肯·汤普逊(Ken Thompson)和罗布·派克(Rob Pike)等人主导开发的,源代码和字符串统一采用 UTF-8 变长编码。
在 UTF-8 编码下,英文字母占 1 个字节,绝大多数常用中文汉字占 3 个字节,极少数生僻字或 Emoji 表情符号则占 4 个字节。
