



在实际项目中,函数通常是一层调用一层的,比如 main() 调用业务层的 getUser(),而 getUser() 又调用数据库层的 findData()。当底层函数报错时,外层函数一般希望在错误信息前面补上一句当前操作的说明,然后再向上返回。
如果我们只是把错误信息拼成一段全新的字符串,原来的底层错误就会丢失,上层调用者也就没法判断最初到底出了什么错。为了解决这个问题,Go 语言提供了 %w 错误包装语法,以及配套的 errors.Is() 和 errors.As() 函数。
包装错误:%w
前面我们使用过 fmt.Errorf() 函数来动态拼接错误文本。如果想在保留原始错误的前提下,为它套上一层新的补充说明,我们可以在 fmt.Errorf() 中使用 %w 占位符。
语法:
wrappedErr := fmt.Errorf("补充说明: %w", err)说明:
其中,%w 是英文单词 “wrap(包装)” 的首字母缩写。它会把原始错误 err 包裹在新生成的错误内部,形成一条由外向内的 “错误链”。
如果想要拆开最外层包装、取出里面包裹的原始错误,我们可以使用 "errors" 包提供的 errors.Unwrap() 函数,其中 unwrap 是英文 “解包” 的意思。
示例 1:使用 %w 包装与解包
package main

import (
    "errors"
    "fmt"
)

// 定义底层预置错误
var ErrNotFound = errors.New("记录不存在")

// 模拟数据库底层查询
func findData() error {
    return ErrNotFound
}

// 模拟业务层调用并包装错误
func getUser() error {
    err := findData()
    if err != nil {
        return fmt.Errorf("查询用户 1001 失败: %w", err)
    }
    return nil
}

func main() {
    err := getUser()
    if err != nil {
        fmt.Println(err)
        fmt.Println(errors.Unwrap(err))
    }
}运行结果如下。
查询用户 1001 失败: 记录不存在
记录不存在
分析:
在这个例子中,底层函数 findData() 返回了 ErrNotFound。业务层函数 getUser() 拿到这个错误后,通过 fmt.Errorf("查询用户 1001 失败: %w", err) 给它套上了一层补充说明,包装后的错误链结构如下图所示。
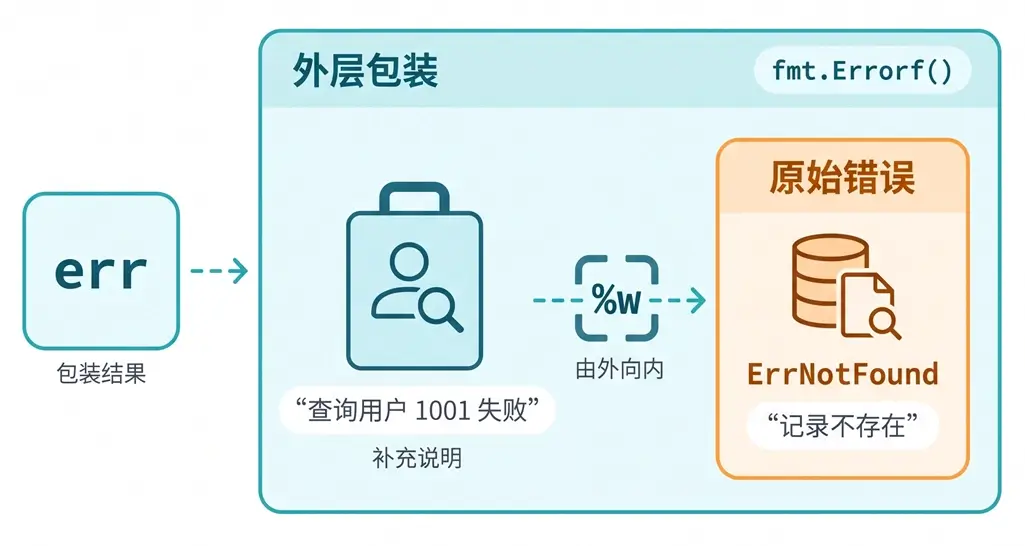
从输出结果可以看出,直接打印 err 会同时显示外层说明和内层原因。而当我们调用 errors.Unwrap(err) 剥离一层外包装后,拿到的就是里面包裹的原始错误 ErrNotFound。
提示: 平时写代码时,我们一般不需要手动调用 errors.Unwrap() 拆包,直接使用下面介绍的 errors.Is() 和 errors.As() 就可以了。另外从 Go 1.20 开始,一条 fmt.Errorf() 还支持同时写多个 %w 包装多个错误。无论是多层包装还是 errors.Join() 合并的错误,它们都能自动向内查找。
判断目标错误:errors.Is()
当一个错误被 %w 包装过之后,它就变成了一个新的外层错误。此时如果还使用相等运算符 == 直接比较,比如写 err == ErrNotFound,结果一定会返回 false。
想要判断错误链中是否包含某个特定的目标错误,我们应该使用 "errors" 包提供的 errors.Is() 函数。
语法:
errors.Is(err, target)说明:
errors.Is() 接收以下 2 个参数:
- err(必选):要检查的错误变量,可以是经过一层或多层
%w包装后的错误。 - target(必选):要对比的目标错误变量,比如预置的
ErrNotFound。
调用后,errors.Is() 会把 err 一层一层剥开往里比对。只要错误链中有任意一层与 target 相等,就会返回 true;如果找遍整条错误链都不相等,则返回 false。
示例 2:多层错误链与 errors.Is()
package main

import (
    "errors"
    "fmt"
)

var ErrNotFound = errors.New("记录不存在")

func getUser() error {
    return fmt.Errorf("查询用户 1001 失败: %w", ErrNotFound)
}

func loadProfile() error {
    err := getUser()
    if err != nil {
        return fmt.Errorf("加载个人资料失败: %w", err)
    }
    return nil
}

func main() {
    err := loadProfile()
    fmt.Println(err)

    // 1. 使用 == 直接比较
    fmt.Println(err == ErrNotFound)

    // 2. 使用 errors.Is() 沿着错误链比较
    fmt.Println(errors.Is(err, ErrNotFound))
}运行结果如下。
加载个人资料失败: 查询用户 1001 失败: 记录不存在
false
true
分析:
在这个例子中,最底层的 ErrNotFound 先后经过 getUser() 和 loadProfile() 两层 %w 包装,最外层拿到的已经是一个全新的错误值。此时直接写 err == ErrNotFound 只会比较最外层,因此返回 false。
而 errors.Is(err, ErrNotFound) 会沿着整条错误链逐层向内拆开,顺利找到藏在最里面的 ErrNotFound,因此返回 true。在判断某个预置错误变量时,我们更推荐使用 errors.Is() 替代传统的 ==。
// 推荐
if errors.Is(err, ErrNotFound) {
    fmt.Println("未查到数据")
}

// 不推荐
if err == ErrNotFound {
    fmt.Println("未查到数据")
}
采用上面的推荐写法,无论底层返回的错误有没有被中间层包装过,判断逻辑都能正常工作。
同样是在 fmt.Errorf() 中拼接错误,使用 %w 和使用 %v 打印出来的文字看起来一模一样,那它们之间有什么区别呢?我们通过一个示例来对比一下。
示例 3:对比 %w 与 %v 的区别
package main

import (
    "errors"
    "fmt"
)

var ErrTimeout = errors.New("请求超时")

func main() {
    // 1. 使用 %w 包装错误
    errW := fmt.Errorf("获取订单列表失败: %w", ErrTimeout)
    fmt.Println(errW)
    fmt.Println(errors.Is(errW, ErrTimeout))

    // 2. 使用 %v 格式化错误
    errV := fmt.Errorf("获取订单列表失败: %v", ErrTimeout)
    fmt.Println(errV)
    fmt.Println(errors.Is(errV, ErrTimeout))
}运行结果如下。
获取订单列表失败: 请求超时
true
获取订单列表失败: 请求超时
false
分析:
从输出结果可以看到,errW 和 errV 打印出来的文字都是 "获取订单列表失败: 请求超时",但调用 errors.Is() 判断时却得出了完全相反的结果。
形象来说,使用 %w 就像是给原来的错误 “套了一个贴有新标签的透明袋子”。原始的 ErrTimeout 完好地保存在 errW 内部,所以 errors.Is() 拆开袋子就能认出它并返回 true。
而使用 %v 则是 “把原错误上的文字抄到了一张新纸条上”。原来的 ErrTimeout 已经被丢弃了,生成的是一个毫无关联的纯文本错误,所以 errors.Is() 返回 false。
提取自定义错误:errors.As()
在实际项目中,底层函数返回的也可能是我们在上一节学过的 *BizError 等自定义错误。一旦它在向上传递时被 %w 包装过,外层再直接写 err.(*BizError) 做类型断言就会匹配失败。
遇到这种情况,我们可以使用 "errors" 包提供的 errors.As() 函数,从错误链中查找并提取出指定类型的自定义错误。
语法:
var target *自定义错误结构体
errors.As(err, &target)
说明:
errors.As() 会沿着 err 的错误链由外向内查找。一旦找到第 1 个匹配 target 类型的错误,就会自动将该错误赋值给 target 变量并返回 true;如果找遍整条错误链都没有匹配的类型,则返回 false。
示例 4:提取被包装的自定义错误
package main

import (
    "errors"
    "fmt"
)

type BizError struct {
    Code int
    Msg  string
}

func (e *BizError) Error() string {
    return fmt.Sprintf("错误码:%d,原因:%s", e.Code, e.Msg)
}

// 模拟底层返回自定义错误并被包装
func login(pwd string) error {
    rawErr := &BizError{Code: 401, Msg: "密码错误"}
    return fmt.Errorf("登录模块报错: %w", rawErr)
}

func main() {
    err := login("000000")
    if err != nil {
        var bizErr *BizError
        // 从错误链中提取 *BizError
        if errors.As(err, &bizErr) {
            fmt.Printf("状态码:%d\n", bizErr.Code)
            fmt.Printf("提示语:%s\n", bizErr.Msg)
        }
    }
}运行结果如下。
状态码:401
提示语:密码错误
分析:
在这个例子中,login() 使用 %w 把 &BizError 包装在了外层错误里。errors.As(err, &bizErr) 找到内层的 *BizError 后,会自动将它的地址赋给 bizErr,随后我们就能读取里面的各个字段了。
可能有些小伙伴会觉得奇怪:“bizErr 前面已经有 * 号了,为什么传给 errors.As() 时还要再加一个 & 呢?” 其实结合前面学过的值传递与指针传递,分两步看就非常清楚了:
- 声明为 *BizError 指针:因为实现
error接口的是结构体指针*BizError,所以用来接收它的变量bizErr本身必须声明为*BizError指针类型,初始值为nil。 - 传入变量地址 &bizErr:Go 语言的函数传参默认是值传递。我们希望
errors.As()在内部修改变量bizErr保存的地址,调用时就必须加上&,把bizErr自己的内存地址传进去。
平时编写这段提取代码时,小伙伴们要注意避开下面这两种常见错误写法。
// 正确方式
var bizErr *BizError
if errors.As(err, &bizErr) {
    fmt.Println(bizErr.Code)
}

// 错误方式 1
var bizErr *BizError
if errors.As(err, bizErr) {
    fmt.Println(bizErr.Code)
}

// 错误方式 2
var bizErr BizError
if errors.As(err, &bizErr) {
    fmt.Println(bizErr.Code)
}
无论是像错误方式 1 那样漏写 & 直接传入 nil 空指针,还是像错误方式 2 那样漏写 * 声明成未实现 error 接口的值类型,程序运行到这里都会直接触发 panic 崩溃。
errors.Is() 与 errors.As() 的区别
很多初学的小伙伴在判断错误时,容易分不清什么时候应该使用 errors.Is(),什么时候应该使用 errors.As()。其实只需要根据我们的使用目的按以下 2 点来区分即可:
- 比对固定的错误变量:当我们只想知道错误链里是否包含
ErrNotFound这类预置错误变量时,使用errors.Is(err, ErrNotFound)。 - 提取自定义错误结构体:当我们想判断错误链里是否包含某种自定义错误,并且需要读取
bizErr.Code等内部字段时,使用errors.As(err, &bizErr)。
