



在 UTF-8 编码下,1 个英文字母占 1 个字节,而 1 个中文汉字通常占 3 个字节。如果我们把包含中文的字符串转为 []byte 切片,一个汉字就会被拆成 3 个独立的字节数字,没办法直接按下标取字或改字。
如果希望不管是英文字母还是中文汉字,都能按照 “1 个完整字符对应 1 个切片元素” 来统计字数、截取或修改字符,就需要使用 []rune(s) 和 string(r) 来互相转换。
string 转 []rune 切片
在 Go 语言中,rune 类型是 int32 的类型别名,专门用来表示一个完整的 Unicode 字符。要把 string 转换为 []rune 字符切片,直接使用 []rune() 把字符串括起来即可。
语法:
r := []rune(s)说明:
其中,s 表示待转换的字符串。转换后得到的 r 是一个 []rune 切片,里面的每一个元素都对应原字符串中的一个完整字符。
示例 1:查看中文字符串的 rune 切片
package main

import "fmt"

func main() {
    s := "Go语言"
    r := []rune(s)    // 按完整字符拆分

    fmt.Println(r)
    fmt.Printf("%c\n", r)
    fmt.Printf("%T\n", r)
}运行结果如下。
[71 111 35821 35328]
[G o 语 言]
[]int32
分析:
[]rune(s) 表示把字符串 "Go语言" 拆成包含 4 个元素的 []rune 切片。因为 rune 本质上是 int32 整数类型,所以 %T 打印出来的是 []int32。
也正因如此,直接使用 fmt.Println(r) 打印时输出的是每个字符对应的十进制 Unicode 编码值。如果想直观看到里面的字符内容,改用 fmt.Printf("%c\n", r) 就会显示 [G o 语 言]。
为了看清 []rune 与 byte 切片在处理中文时的差别,下面我们把两者的长度放在一起对比一下。
示例 2:对比 []byte 与 []rune 的长度
package main

import "fmt"

func main() {
    s := "Go语言"
    b := []byte(s)    // 按单字节拆分
    r := []rune(s)    // 按完整字符拆分

    fmt.Println(len(b))
    fmt.Println(len(r))
    fmt.Printf("%c\n", r[2])
}运行结果如下。
8
4
语
分析:
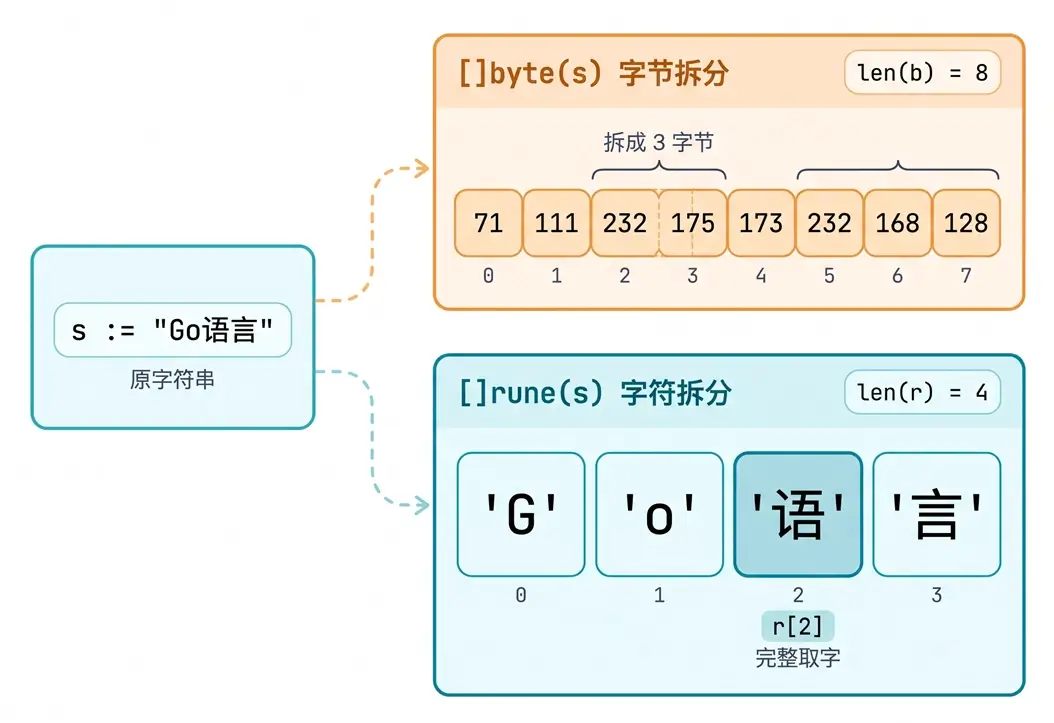
字符串 "Go语言" 包含 2 个英文字母和 2 个中文汉字。由于 2 个英文字母占 2 个字节、2 个汉字占 6 个字节,转为 []byte 后的长度为 8。
而转为 []rune 后是按完整字符拆分的,长度为 4,此时通过下标 r[2] 就能准确取出第 3 个字符 '语'。两者的拆分结构对比如下图所示。
提示: 在实际开发中,统计字符个数 len([]rune(s)),以及处理包含中文的字符串截取与字符串反转,底层利用的都是 []rune(s) 按完整字符拆分的特性。如果只想统计字数而不需要修改字符,也可以导入 "unicode/utf8" 包并调用 utf8.RuneCountInString(s),能省去一次切片内存分配。
[]rune 切片转 string
对 []rune 切片处理完毕后,如果想把它还原成 string 字符串,同样直接使用 string() 把切片括起来就可以了。
语法:
s := string(r)说明:
其中,r 表示一个 []rune 字符切片。string(r) 会把切片中的所有字符依次组合起来,生成一个新的 string 字符串。
示例 3:将字符切片还原为字符串
package main

import "fmt"

func main() {
    r := []rune{'绿', '叶', '网', 'G', 'o'}
    s := string(r)

    fmt.Println(s)
    fmt.Printf("%T\n", s)
}运行结果如下。
绿叶网Go
string
分析:
string(r) 把包含 3 个汉字和 2 个英文字母的 []rune 切片还原成了字符串 "绿叶网Go"。可以看到,无论是 []byte 切片还是 []rune 切片,转回 string 的语法是完全一样的。
由于 1 个汉字占 3 个字节,对 "我爱学Go" 直接写 s[:3] 只能取出 1 个 "我" 字,写 s[:4] 更会把第 2 个汉字劈成两半导致乱码。如果想要安全地修改某个汉字或按字数截取前 3 个字,应该怎么配合 []rune 来实现呢?下面来看一个例子。
示例 4:修改与截取中文字符串
package main

import "fmt"

func main() {
    s := "我爱学Go"
    r := []rune(s)          // 转为 []rune 切片
    r[0] = '你'             // 修改第 1 个汉字
    sub := string(r[:3])    // 截取前 3 个字符并转回 string
    res := string(r)        // 将修改后的切片转回 string

    fmt.Println(sub)
    fmt.Println(res)
}运行结果如下。
你爱学
你爱学Go
分析:
在这个例子中,我们先通过 []rune(s) 把 "我爱学Go" 转为字符切片 r。此时每个汉字和英文字母在切片里都只占 1 个位置,我们既可以通过 r[0] = '你' 直接替换第 1 个汉字,也能调用 string(r[:3]) 准确取出前 3 个字 "你爱学"。
这里小伙伴们要特别注意,[]rune 切片里的每个元素都是字符类型(rune),赋值时必须使用英文单引号。下面这种使用英文双引号赋值的写法是错误的。
r := []rune("我爱学Go")
r[0] = "你"    // 编译报错
双引号 "你" 表示的是字符串(string),不能直接赋给 rune 类型的切片元素,编译时会直接报错。
平时写代码时,小伙伴们根据实际操作目标来选 []byte(s) 还是 []rune(s) 就可以了:
- []byte(s):按单字节拆分,我们在做文件读写、网络传输、JSON 解析或纯英文字符处理时优先使用它。
- []rune(s):按完整字符拆分,我们需要对包含中文的文本统计字数、按下标改字或按字数截取子串时应该使用它。
