



截取字符串也叫做获取 “子字符串”(substring)。在 Go 语言中,它的语法与前面学过的切片截取完全一致,都是使用方括号 s[start:end] 提取指定范围内的内容。
不过初学的小伙伴在这里很容易踩坑:s[start:end] 默认是按底层的 “字节” 位置来截取的。如果字符串里包含中文汉字,直接按字节截取很容易把一个汉字拆成两半,打印出来就会出现乱码。
截取纯英文字符串
在 Go 语言中,当字符串只包含英文字母、数字或英文半角符号时,每个字符固定占用 1 个字节。此时字节下标刚好等于字符位置,我们可以使用 s[start:end] 进行截取。
语法:
sub := s[start:end]说明:
截取区间遵循 “左闭右开” 原则,也就是包含起始下标 start 对应的字符,但不包含结束下标 end 对应的字符,截取出的字节长度为 end - start。
与切片一样,起始下标和结束下标也可以按需省略,常见的有以下 2 种简写形式:
- 省略起始下标:写成
s[:end],默认从下标 0 开始,一直截取到end之前。 - 省略结束下标:写成
s[start:],默认从start位置开始,一直截取到字符串末尾。
示例 1:截取纯英文字符串
package main

import "fmt"

func main() {
    s := "Hello, Go"

    fmt.Println(s[0:5])    // 截取下标 0~4 的字符
    fmt.Println(s[:5])     // 从头开始截取
    fmt.Println(s[7:])     // 截取到末尾
}运行结果如下。
Hello
Hello
Go
分析:
s[0:5] 表示从下标 0 开始截取到下标 5 之前,实际取出的是下标 0~4 共 5 个字母(5 - 0 = 5),因此输出 "Hello"。从开头截取时起始下标 0 可以省略,所以 s[:5] 的结果同样是 "Hello"。
在字符串 "Hello, Go" 中,下标 5 是英文逗号 ',',下标 6 是空格 ' ',字母 'G' 的下标是 7。因此执行 s[7:] 时,程序会从下标 7 一直截取到末尾,输出 "Go"。
另外小伙伴们要注意区分 s[0] 和 s[0:1]:单独写下标 s[0] 取出的是第 1 个字节的编码值(byte 类型,值为 72),而带冒号的 s[0:1] 截取出来的才是包含首字母的子字符串 "H"(string 类型)。
注意: 在 Go 语言中,字符串截取不支持负数下标(如 s[-2:]),且下标必须满足 0 <= start <= end <= len(s)。一旦越界,程序运行时会报 slice bounds out of range(截取边界超出范围)错误并崩溃。
截取包含中文的字符串
如果字符串中包含中文汉字,还能直接按 “第几个字” 去写 s[start:end] 吗?答案是不能。前面学习字符串长度时我们看到,一个常用汉字占 3 个字节,而 s[start:end] 始终是按字节位置去切分的。
假如我们想截取前两个汉字,直接写 s[0:2] 只会切出第 1 个汉字的前 2 个字节,连一个完整的汉字都没凑齐,打印出来就会变成乱码。下面我们先看一个例子。
示例 2:按字节截取中文乱码
package main

import "fmt"

func main() {
    s := "绿叶网学Go"

    fmt.Println(s[0:2])    // 只切 2 个字节导致乱码
    fmt.Println(s[0:6])    // 切满 6 个字节拿到前两个汉字
}运行结果如下。
�
绿叶
分析:
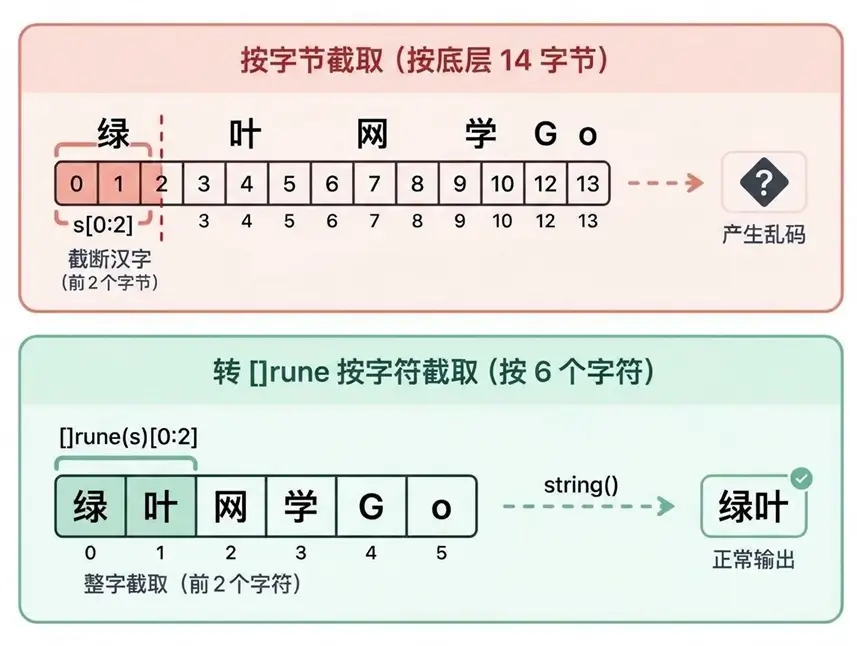
"绿叶网学Go" 的前两个汉字各占 3 个字节。执行 s[0:2] 时只取出了 '绿' 字的前 2 个字节,凑不够一个完整的汉字,因此第 1 行输出了乱码替换符。而 s[0:6] 刚好取满前 6 个字节,第 2 行就能正常输出 "绿叶"。
不过文本经常是中英文混排的,我们总不能每次截取前都手动数每个字占几个字节。遇到含中文的字符串,可以先通过 []rune(s) 将它转换为 rune 切片,按字符位置截取完,再使用 string() 转回字符串。两者的区别如下图所示。
语法:
runes := []rune(s)
sub := string(runes[start:end])
说明:
转换为 []rune 切片后,切片里的每一个元素都代表一个完整的字符,不管是英文字母还是中文汉字都只占 1 个位置。此时 runes[start:end] 就是严格按 “第几个字符” 来截取了。
示例 3:转为 []rune 截取中文
package main

import "fmt"

func main() {
    s := "绿叶网学Go"
    runes := []rune(s)            // 转为 []rune 切片

    sub1 := string(runes[0:3])    // 截取前 3 个字符
    sub2 := string(runes[3:])     // 从下标 3 截取到末尾

    fmt.Println(sub1)
    fmt.Println(sub2)
}运行结果如下。
绿叶网
学Go
分析:
runes := []rune(s) 把 "绿叶网学Go" 拆成了包含 6 个元素的字符切片(下标为 0~5)。接着 runes[0:3] 取出前 3 个字并转回 "绿叶网",runes[3:] 则一直取到末尾得到 "学Go"。
需要注意的是,转为 []rune 切片后,判断字符总长度应该使用 len(runes)(结果为 6)。小伙伴们不要误用原字符串的字节数 len(s)(结果为 14),否则会导致切片下标越界报错。
如果只需要截取一次,我们也可以把这几步合写成一行。对于截取前 3 个字符来说,下面 2 种写法是等价的。
// 写法 1
runes := []rune(s)
sub := string(runes[0:3])

// 写法 2
sub := string([]rune(s)[0:3])
对同一个字符串多次截取时,推荐使用写法 1 先存好 runes 变量复用;只截取一次时,写法 2 更简练。小伙伴们只需要记住一句话:纯英文和数字直接使用 s[start:end],包含中文汉字先转 []rune(s) 再截取。
